Hallo,

für ein Roboterprojekt soll eine einzige menschliche Stimme mit einem
Lautsprechersystem nachgebildet werden.

Im Moment werden Sprachsamples über eine kleine Lautsprecherbox
abgspielt. Das klingt aber nicht nach einer natürlichen Stimme.

Deshalb ist meine Idee, statt einer Lautsprecherbox irgendwie mechanisch
den menschlichen Resonanzapparat nachzubilden. Im einfachsten Fall mit
einem Resonanzrohr bestimmter Länge, das an einer Seite mit einem
Lautsprecher verschlossen ist.

Könnte das funktionieren oder gibt es bessere Möglichkeiten?

Es kommt nicht darauf an, eine bestimmte Stimme naturgetreu
wiederzugeben, sondern die entstehende Stimme soll wie eine menschliche
Stimme in Natura klingen.

(hoffe, ich konnte verständlich ausdrücken, worum es mir geht?!)
Moin,

der Haken an der Sache ist eher nicht der Wandler von elektrisch auf
mechanisch, sondern die Erzeugung.

Will sagen, wie du den Schall erzeugst ist irrelevant. Die Intonation
ist dein Problem. Die Samples werden nicht anders klingen. Die Kunst
wird in der Software liegen.
TMG schrieb:> für ein Roboterprojekt soll eine einzige menschliche Stimme mit einem> Lautsprechersystem nachgebildet werden.>> Im Moment werden Sprachsamples über eine kleine Lautsprecherbox> abgspielt. Das klingt aber nicht nach einer natürlichen Stimme.>> Deshalb ist meine Idee, statt einer Lautsprecherbox irgendwie> mechanisch den menschlichen Resonanzapparat nachzubilden.
Hervorragende Idee! Schließlich werden in Radios und Fernsehern ja auch
keine Lautsprecher verwendet, um menschliche Stimmen wiederzugeben.
Vollkommen klar, daß man dafür niemals nie keinen Lautsprecher nicht
verwenden kann!!1!elf!
Eine Vokaltracknachbildung wurde schon im letzten Jahrtausend von
Klatt beschrieben:
http://sova.si.edu/record/NMAH.AC.0417/

Auch darauf aufbauend gab es Chips von Votrax "SC-01" und ---
auch "SC-02" mit mehr fuer europaeische Sprachen nuetzliche Phonemen.
Ebenso SI-263 ... vor 30 Jahren. Ab und zu gibt es auf eBay mal
das ein oder andere Vintage-IC davon zu noch kaufen....

Softwareseitig hat es "Klatt"-Implementierungen auf dem C64 und dem
Atari gegeben u.a. mit Beispielen, die die Roboterstimme haben singen
lassen ;-) Auf youtube sollten sich auch bei Eingabe von "VOTRAX"
entspechende unterhaltende Samples finden lassen.

Viel Glueck!
TMG schrieb:> sondern die entstehende Stimme soll wie eine menschliche> Stimme in Natura klingen
Das ist nicht einfach. In den meisten Fällen kann man leicht
unterscheiden, ob jemand nebenan spricht oder ob da ein Radio läuft.
Für einen ersten Versuch würde ich einem Lautsprecher mit möglichst
leichter Membran, einer Resonanzfrequenz zwischen 250 bist 300 Hz wählen
und unsymmetrisch auf eine Schallwand montieren.
Für noch erfolgversprechender halte ich einen Hornlautsprecher mit
ähnlicher Grenzfrquenz.
Axel S. schrieb:>> Deshalb ist meine Idee, statt einer Lautsprecherbox irgendwie>> mechanisch den menschlichen Resonanzapparat nachzubilden.>> Hervorragende Idee! Schließlich werden in Radios und Fernsehern ja auch> keine Lautsprecher verwendet, um menschliche Stimmen wiederzugeben.
Ausgerechnet von dir hätte ich so eine Antwort nicht erwartet.
TO:
> nachzubilden
Du:
> wiederzugeben
Fällt dir was auf? ;-)
Allu schrieb:>> sondern die entstehende Stimme soll wie eine menschliche>> Stimme in Natura klingen>> Das ist nicht einfach. In den meisten Fällen kann man leicht> unterscheiden, ob jemand nebenan spricht oder ob da ein Radio läuft.
So ist es!
Allu schrieb:> Für einen ersten Versuch würde ich einem Lautsprecher mit möglichst> leichter Membran, einer Resonanzfrequenz zwischen 250 bist 300 Hz wählen> und unsymmetrisch auf eine Schallwand montieren.
So einen Lautsprecher habe ich. Was bedeutet unsymmetrisch auf eine
Schallwand montieren?
Allu schrieb:> Für noch erfolgversprechender halte ich einen Hornlautsprecher mit> ähnlicher Grenzfrquenz.
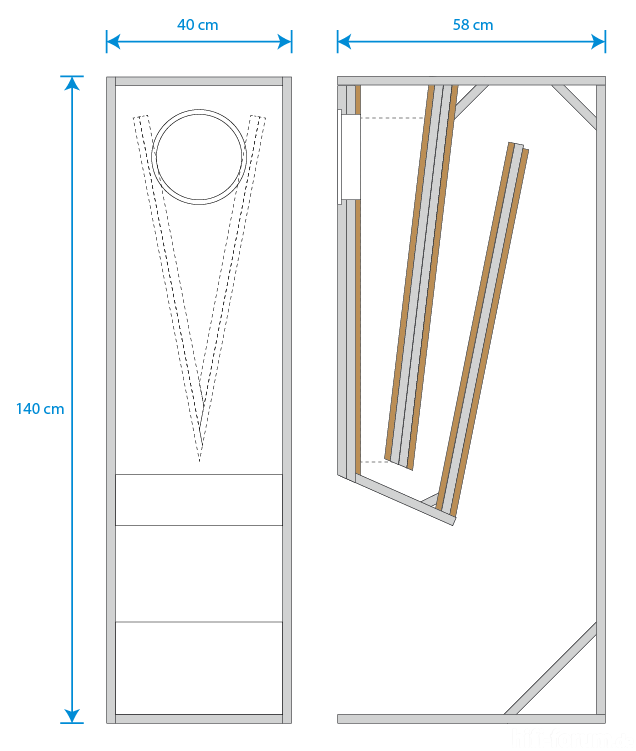
Könnte man vielleicht aus Sperrholz bauen nach diesem Prinzip:
http://bilder.hifi-forum.de/max/613254/hornlautsprecher-fur-ciare-ch201_126644.png
Axel S. schrieb:> Vollkommen klar, daß man dafür niemals nie keinen Lautsprecher nicht> verwenden kann!!1!elf!
Wenn Du stattdessen schreibst: "Vollkommen klar, daß man dafür niemals
nie einen kleinen Lautsprecher verwenden kann", stimmts sogar. :-)
Das Problem ist, dass die menschliche Stimme nicht durch einen einzigen
Schallwandler abgestrahlt wird, sondern über ein hochkomplexes
Mehfachsystem mit jeweils eigener, charakteristischer Geometrie,
Resonanz, Obertongemische und Abstrahlrichtung (Mund, Wangen, Hals,
Nase, Brustkorb, Zwerchfell...). Es wird wohl sytembedingt unvollkommen
bleiben, wenn man versucht diese Komplexität über ein einfaches Wandler-
und Abstrahlsystem nachzubilden. Dabei kommt die Kunstkopfstereophonie
dem Gewünschten bislang am Nächsten, erfordert allerdings Kopfhörer und
kann die tiefen Brusttöne auch nicht sensorisch exakt vermitteln.

Nichts desto trotz, würde ich auch über einen richtig miesen
Lautsprecher sofort unseren Englisch-Koryphäe, alias Öttinger, unfehlbar
an seiner Stimme und Sprechweise erkennen. Auch mit oettingerfreien 2
Promille im Blut... ;-)
Simpel schrieb:> Das Problem ist, dass die menschliche Stimme nicht durch einen einzigen> Schallwandler abgestrahlt wird, sondern über ein hochkomplexes> Mehfachsystem mit jeweils eigener, charakteristischer Geometrie,> Resonanz, Obertongemische und Abstrahlrichtung (Mund, Wangen, Hals,> Nase, Brustkorb, Zwerchfell...).
Deshalb schrieb der TO auch:
TMG schrieb:> Deshalb ist meine Idee, statt einer Lautsprecherbox irgendwie mechanisch> den menschlichen Resonanzapparat nachzubilden.
Wobei ich stark bezweifle, daß man diesen so einfach nachbilden kann
und vor allem ihn so bewegen und verändern kann, daß die Artikulation
richtig stattfindet. Das ist wohl schon mal gemacht worden, aber mit
immensem Aufwand und garantiert nicht zu Hause am Wohnzimmertisch.
TMG schrieb:> So einen Lautsprecher habe ich. Was bedeutet unsymmetrisch auf eine> Schallwand montieren?
Unsymmetrisch deshalb, damit sich die Auslöschung von bestimmten
Frequenzen durch akustischen Kurzschluss nicht so selektiv und stark
auswirkt, sondern sich über einen größeren Frequenzbereich abgeschwächt
verteilt. Ziel ist die Entfernungen zwischen Vorderseite und Rückseite
des Lautsprechers über viele unterschiedliche Entfernungen zu verteilen.
TMG schrieb:> Könnte man vielleicht aus Sperrholz bauen nach diesem Prinzip:> http://bilder.hifi-forum.de/max/613254/hornlautsprecher-fur-ciare-ch201_126644.png
Im Prinzip ja. Ein Horn erhöht den Strahlungswiderstand enorm, bewirkt
dadurch ein exakteres Ein- und Ausschwingen und erhöht den Wirkungsgrad
erheblich. Für ausschliesslich Sprache kann das Horn viel kleiner
ausfallen.
Übrigens lässt sich ähnliches auch mit einer Schallwand erreichen.
Montiert man statt einem vier Lautsprecher verbessert sich ebenfalls der
Strahlungswiderstand und der Wirkungsgrad verdoppelt sich auch in etwa.
Wenn es wirklich um eine Stimmnachbildung geht, ist der mechanische
Aufwand ziemlich groß. Mit irgendwelchen Holzkisten und
Lautsprechermembranen kommt man da nicht allzu weit, denn sie ähneln so
wirklich gar nicht dem menschlichen Spracherzeugungs- und
abstrahlsystem. Abgesehen von den Zähnen befinden sich ja ausschließlich
recht weiche und damit stark dämpfende Materialien im Signalweg. Auch
auch die Zähne dürften keine Resonanzen ausbilden, weil sie stark
gedämpft in den Kiefern aufgehängt sind.

Aber in der Tat wurde erst vor kurzer Zeit von japanischen Forschern
eine Nachbildung des Spracherzeugungssystems vorgestellt, die schon
deutlich an eine menschliche Stimme erinnern. Allzu komplexe Laute
können damit aber noch nicht erzeugt werden. Der Aufbau erinnert auch
eher auch eine Kreuzung aus einem Fisch und einer Taschenvagina als an
einen Lautsprecher oder Kopf.

Wenn es also um eine nach derzeitigem technischen Stand bestmögliche
Sprachausgabe geht, ist die Wiedergabe von Sprachsamples oder
elektronisch erzeugter Sprache über herkömmliche Lautsprecher die
Methode der Wahl.
Vielen Dank für die aufschlussreichen Antworten!
Simpel schrieb:> Es wird wohl sytembedingt unvollkommen> bleiben, wenn man versucht diese Komplexität über ein einfaches Wandler-> und Abstrahlsystem nachzubilden.Erwin D. schrieb:> Wobei ich stark bezweifle, daß man diesen so einfach nachbilden kann> und vor allem ihn so bewegen und verändern kann, daß die Artikulation> richtig stattfindet.
Bewegte mechanische Teile sollen nicht verwendet werden. Vielleicht gibt
es aber einen halbwegs einfachen mechanischen Aufbau, bei dem die
eingesampleten Wörter bei der Wiedergabe wesentlich naturgetreuer
klingen als bei einer herkömmlichen Lautsprecherbox.
Oben hat jemand einen Hornlautsprecher mit einer Resonanzfrequenz um
300Hz vorgeschlagen, das wäre ja schon mal ein Ansatz.
Andreas S. schrieb:> Abgesehen von den Zähnen befinden sich ja ausschließlich> recht weiche und damit stark dämpfende Materialien im Signalweg.
Ein wichtiger Punkt!
TMG schrieb:> für ein Roboterprojekt soll eine einzige menschliche Stimme mit einem> Lautsprechersystem nachgebildet werden.
Wo zum Teufel soll dabei ein Problem entstehen?
> Im Moment werden Sprachsamples über eine kleine Lautsprecherbox> abgspielt. Das klingt aber nicht nach einer natürlichen Stimme.
Dann stimmt irgendwas nicht. Denn natürlich wird eine Aufzeichnung einer
menschlichen Stimme naturgetreu wiedergegeben werden, wenn alles stimmt.
> Deshalb ist meine Idee, statt einer Lautsprecherbox irgendwie mechanisch> den menschlichen Resonanzapparat nachzubilden.
Ja, klar. Wenn ich nicht in der Lage bin, gundlegendste Trivialitäten
korrekt umzusetzen, dann brauch ich natürlich unbedingt einen
esotherisch vergoldeten Schallwandler...
Kommst du irgendwie aus der HiFi-Ecke?
c-hater schrieb:> Ja, klar. Wenn ich nicht in der Lage bin, gundlegendste Trivialitäten> korrekt umzusetzen, dann brauch ich natürlich unbedingt einen> esotherisch vergoldeten Schallwandler...
Die grundlegende Trivialität ist es, die Begriffe "Sprachwiedergabe" und
"nachbilden" auseinander zu halten.
Andreas hat es verstanden. Warum du nicht? Und warum fängst du schon
wieder an, andere zu beschimpfen?
Andreas S. schrieb:> Aber in der Tat wurde erst vor kurzer Zeit von japanischen Forschern> eine Nachbildung des Spracherzeugungssystems vorgestellt, die schon> deutlich an eine menschliche Stimme erinnern. Allzu komplexe Laute> können damit aber noch nicht erzeugt werden.
Wozu sollen den Stimmen mechanisch nachgebildet werden? So eine
"Mechanik" wird die menschlichen Stimmlippen kriegt man eh nie hin
geschweige denn die Steuerung derselben sowie die Mundlippen. Selbst
viele Meschen packen es ja nicht, diese Werkzeuge tauglich einzusetzen.
Die Schwaben und allen voran der Öttinger, sind das beste Beispiel!
An alle die sich an "nachbilden" vs. "wiedergeben" abarbeiten:

Selbstverständlich kann kein Lautsprecher der Welt die menschliche
Stimme nachbilden (im Wortsinn). Die Nachbildung erfolgt immer auf
elektronischem Weg, entweder per Sprachsynthesizer oder durch die
Aneinanderreihung vorher aufgezeichneter Floskeln. Die Ergebnisse
klingen beide Male künstlich.

Aber der Stand der Technik schreitet voran und wir wissen ja nicht,
welchen Ansprüche an die Natürlichkeit der TO denn wirklich stellt.
In jedem Fall besteht die Aufgabe des Lautsprechers aber immer nur
darin, das erzeugte Stimmensignal wiederzugeben.

BTW, bin ich eigentlich der einzige, der sich fragt warum man für ein
Roboterprojekt eine möglichst natürlich klingende menschliche Stimme
haben wollen würde?

Ich kenne das eher anders herum. Früher haben wir mit Vocodern oder
Modulatoren versucht, unsere Stimme auf "Roboter" zu verändern. Für
Fasching und ähnliches.

Ist das ein Zeichen von Alter, daß ich nicht mal mehr die Intentionen
der Jugendlichen nachvollziehen kann?
TMG schrieb:> für ein Roboterprojekt soll eine einzige menschliche Stimme mit einem> Lautsprechersystem nachgebildet werden.
Wo liegt Dein Problem?
Ein Lautsprecher bringt das herüber, was ihm zugeführt wird..
Also Gekrächtze, Rauschen, Musik oder Stimme...
TMG schrieb:> Hallo,>> für ein Roboterprojekt soll eine einzige menschliche Stimme mit einem> Lautsprechersystem nachgebildet werden.>> Im Moment werden Sprachsamples über eine kleine Lautsprecherbox> abgspielt. Das klingt aber nicht nach einer natürlichen Stimme.
Wieso nicht? Wenn die Aufnahme gut ist (sauber gesprochen und intoniert,
vernünftig ausgesteuert, nicht verrauscht, keine Störgeräusche wie
draußen vorbeifahrende Autos etc.), dann gibt es keinen prinzipiellen
Grund warum sie bei der Wiedergabe nicht gut klingen sollte. Die
Hardware dafür, also D/A-Wandler, Verstärker, Lautsprecher sollte
natürlich nicht das Billigste vom Billigsten sein - versteht sich.
> Deshalb ist meine Idee, statt einer Lautsprecherbox irgendwie mechanisch> den menschlichen Resonanzapparat nachzubilden. Im einfachsten Fall mit> einem Resonanzrohr bestimmter Länge, das an einer Seite mit einem> Lautsprecher verschlossen ist.>> Könnte das funktionieren oder gibt es bessere Möglichkeiten?
Es gibt vor allem sehr viel einfachere Möglichkeiten.
> Es kommt nicht darauf an, eine bestimmte Stimme naturgetreu> wiederzugeben, sondern die entstehende Stimme soll wie eine menschliche> Stimme in Natura klingen.
Das tut die Aufnahme eines menschlichen Sprechers doch wohl.
> (hoffe, ich konnte verständlich ausdrücken, worum es mir geht?!)
Nein, irgendwie nicht.
Geht es Dir darum, bestimmte vorher aufgezeichnete Texte sprechen zu
lassen? Oder sollen es vollkommen beliebige Texte sein, so dass man eben
nicht einfach vorher aufnehmen kann was man später hören soll?
Auch für den letzteren Fall gibt es schon Etliches an fertiger Software.
Somit besteht mal wieder - wer hätte das gedacht - kein Grund, das Rad
neu zu erfinden. Mal abgesehen davon, dass es viel zu lange dauern würde
so etwas komplett selbst zu entwickeln.
Der japanische Professor, dessen System oben verlinkt wurde, arbeitet
übrigens schon seit über zehn Jahren an diesem Thema. Da wage ich doch
sehr zu bezweifeln, dass man etwas Ähnliches mal eben kurz nachbaut.
Siehe hier für eine Übersicht verschiedener Software zur Erzeugung von
Sprache:
https://en.wikipedia.org/wiki/Comparison_of_speech_synthesizers
Ich hatte mal von einem Experiment gelesen, wo man die Interaktion
zwischen Robotern und Menschen untersucht hat.

Dabei kam heraus, dass das Nachahmen Menschlicher Eigenschaften (Stimme,
Aussehen, Mimik, Körperbau) für eine erfolgreiche Kommunikation sogar
hinderlich sind.

Die Probanten kamen besser mit Robotern zurecht, die nicht wie Menschen
aussahen und ander kommunizierten. Die Forscher waren Überrascht, dass
Antworten via Lichtzeichen und Pieptöne (wie bei R2D2) praktisch genau
so effizient funktionierten, wie einfache Sprache und Mimik.

Die Menschen haben die völlig fremde Sprache der Roboter schneller
angenommen, als halbgare Mimik und schlechte Künstliche Sprachausgabe.
Andreas S. schrieb:> Abgesehen von den Zähnen befinden sich ja ausschließlich> recht weiche und damit stark dämpfende Materialien im Signalweg. Auch> auch die Zähne dürften keine Resonanzen ausbilden, weil sie stark> gedämpft in den Kiefern aufgehängt sind.
Das unterschätze mal nicht :-) Das Gewebe ist zwar an sich weich,
besteht aber aus kaum kompressiblem Wasser, das den Schall direkt
ungedämpft nach hinten leitet. Die Schädel- und Gaumenreflektionen sind
dabei sehr entscheidend bei der Formantenbildung und stark klanggebend.
Auch knochenfreies Gewebe reflektiert noch gut und kann besonders die
Hohen stark ablenken. Daher kann man ja die Verständlichkeit von
entfernten Schallquellen steigern, wenn man mit der Hand die Ohrmuschel
vergrössert.
Die Zähne sind durchaus auch hart "aufgehängt" (mal draufklopfen) -
allerdings sind die zu klein und beeinflussen nur die höchsten Höhen.
Sie dienen aber der Zunge als Anschlag und sind mit das Wichtigste bei
der Tonerzeugung, was die Explosivlaute angeht.
Wenn man sowas nachbilden will, müsste man den Kehlkopf simulieren, der
zusammen mit der Luftsäule im Bauch den größten Anteil hat. Ob das
jemals vernüftig geht, wage ich mal zu bezweifeln.
> Aber in der Tat wurde erst vor kurzer Zeit von japanischen Forschern> eine Nachbildung des Spracherzeugungssystems vorgestellt, die schon> deutlich an eine menschliche Stimme erinnern.
Das ist interessant. Hättest Du einen link?
Jürgen S. schrieb:> Andreas S. schrieb:>> Aber in der Tat wurde erst vor kurzer Zeit von japanischen Forschern>> eine Nachbildung des Spracherzeugungssystems vorgestellt, die schon>> deutlich an eine menschliche Stimme erinnern.>> Das ist interessant. Hättest Du einen link?
Ist der Link von oben, der Mann heißt Professor Hideyuki Sawada.
Jürgen S. schrieb:> Das unterschätze mal nicht :-) Das Gewebe ist zwar an sich weich,> besteht aber aus kaum kompressiblem Wasser, das den Schall direkt> ungedämpft nach hinten leitet.
Ich habe nur eine Aussage bezüglich des Entstehens von Resonanzen
getroffen. Über den Schalltransport habe ich nichts geschrieben.
Natürlich findet dieser auch über weiche Materialien oder weich
aufgehängte harte Materialien, z.B. das Trommelfell oder die
Gehörknochen, statt. Ansonsten wären wir taub.
> Die Schädel- und Gaumenreflektionen sind> dabei sehr entscheidend bei der Formantenbildung und stark klanggebend.
Die Reflektionen entstehen aber hauptsächlich durch den
Dichteunterschied zwischen Luft und Körpergewebe. Das Äquivalent in der
Optik wäre die Lichtreflektion an einer harten Glasscheibe oder einer
"weichen" Wasseroberfläche. Wenn die Wasseroberfläche ruht, sieht man
auch kaum einen Unterschied.
Ganz wesentlich ist vor allem auch die zeitliche Veränderung der Form
der relevanten Hohlräume und deren Verbindungen miteinander, d.h. durch
Kehlkopfdeckel, Gaumelsegel und Zunge. Eine Sonderstellung besitzen
natürlich die Stimmlippen, deren Vibrationen ja tatsächlich direkt
tonhöhenbestimmend sind. Allerdings sind auch hier nicht die Stimmlippen
selbst der Resonator, sondern die zerhackte Luftsäule in der Luftröhre
und im Rachenraum.
> Auch knochenfreies Gewebe reflektiert noch gut und kann besonders die> Hohen stark ablenken. Daher kann man ja die Verständlichkeit von> entfernten Schallquellen steigern, wenn man mit der Hand die Ohrmuschel> vergrössert.
Die Ohrmuschel sorgt für eine akustische Impedanzanpassung zwischen der
Luft und dem ansonsten stark reflektierenden Trommelfell. Aber auch die
mechanische Übersetzung der Trommelfellbewegung durch die Gehörknochen
auf das Fenster der Hörschnecke dient dieser Impedanzanpassung.
Theoretisch könnte ja auch einfach das Fenster der Hörschnecke selbst
die Rolle des Trommelfells übernehmen, aber offenbar wäre die
Impedanzanpassung viel zu schlecht.
> Die Zähne sind durchaus auch hart "aufgehängt" (mal draufklopfen) -> allerdings sind die zu klein und beeinflussen nur die höchsten Höhen.
Auch bei den alveolaren Plosiven erfolgt die Klangerzeugung durch die
Modulation des Phonationsstromes und nicht durch das Aufeinandertreffen
der Zähne. Sogar bei den dentalen Frikativen geht es nicht um die
Reibung der Zähne aneinander, sondern um die Reibung des Luftstroms an
Engstellen im Zahnbereich. Sofern man nicht ganz bewusst die Zähne
aufeinanderdrückt, sind eigentlich immer auch die Zunge und/oder die
Lippen an der Bildung der Engstelle beteiligt.
> Sie dienen aber der Zunge als Anschlag und sind mit das Wichtigste bei> der Tonerzeugung, was die Explosivlaute angeht.
Bei der Explosivlauten geht es aber nicht um die Zähne, sondern um eine
komplette Unterbrechung des Phonationsstroms mit Hilfe der Zunge oder
der Lippen.
> Wenn man sowas nachbilden will, müsste man den Kehlkopf simulieren, der> zusammen mit der Luftsäule im Bauch den größten Anteil hat.
Ich kann mir vorstellen, dass durch die immer stärkere Verästelung der
Luftröhre in der Luftröhre, den Bronchien, Bronchiolen und zuletzt
Alveolen eine sehr gute Impedanzanpassung erfolgt, allerdings unter
Inkaufnahme einer starken Schalldämpfung durch die schwammartige
Struktur der Lunge. Dass hierbei auch recht hohe Kräfte und Energien
zwischen Luft und Lungengewebe ausgetauscht werden können, sieht man
daran, dass sehr laute, basslastige Musik zum Lungenriss führen kann.
> Ob das jemals vernüftig geht, wage ich mal zu bezweifeln.
Ob das jemals eine relevante technische Bedeutung erlangen wird, wage
ich mal zu bezweifeln.
> Das ist interessant. Hättest Du einen link?
Ich konnte leider keine neueren Videos als von 2010/2011 finden, bin mir
aber sicher, irgendwann eine deutlich verbesserte Version gesehen zu
haben.
https://www.youtube.com/watch?v=HmSYnOvEueo
Andreas S. schrieb:> Die Reflektionen entstehen aber hauptsächlich durch den> Dichteunterschied zwischen Luft und Körpergewebe.
Den Vergleich zur Optik würde ich hier nicht ziehen. Es geht schon um
den Massenunterschied. Das dünne Gewebe im Mund wäre ohne Schädelplatte
ziemlich durchlässig. Nur, die Höhen ab etwa 2kHz dringen überwiegend
aus dem Mund heraus. Tiefere Frequenzen dringen aus auch dem Hals, z.B.
aus dem Kopf und die Tiefen sogar überwiegend aus dem Bauch. Das Problem
hat man immer bei Tonaufnahmen, wenn man bei klassischem Gesang zu dicht
am Kopf ist und zu sehr auf den Mund richtet. Umgekehrt, verliert man
die Deutlichkeit, sobald sich der Kopf dreht.
Meines Erachtens spielt hier der psychologische Faktor eine Hauptrolle.
Man kann eine menschliche Stimme von einem Lautsprecher auch deshalb gut
unterscheiden, weil man weiß, dass da ein Mensch ist und seine Gegenwart
anderweitig vermittelt bekommt (nonverbale Reize & Geräusche sowie
Gerüche, die eine Gegenwart unterbewusst vermitteln.).

Die Beste Lösung scheint mir eine Lautsprecher/Verstärker- Kombination
zu sein, deren Frequenzgang möglichst naturgetreu das widergibt, was
zuvor mit einem hochpräzisen Mikrofon (Frequenzgang) aufgezeichnet
wurde.

Unter diesen Voraussetzungen (sehr teuer) sollte ein Unterschied nicht
hörbar sein.
Jürgen S. schrieb:> Ich glaube, er will nicht nur aufgenommenes abspielen, er will es> ERZEUGEN.
Da der Themenersteller sang- und klanglos(!) verschwunden ist, ist es
wohl müßig zu spekulieren was er nun eigentlich will oder eigentlich
braucht.
Das ist in diesem Forum mittlerweile normal. Irgend ein Student will für
seine Hausaufgabe oder Studienarbeit einen Tipp und stellt die Thematik
in mehreren Foren zur Diskussion. Dann fährt man gemütlich in den Urlaub
und liest sich nach 2 Wochen die Ergebnisse durch die die Experten
beigetragen haben. So erspart man sich Literaturrecherche und gfs einen
falschen Ansatz.

Was ist das Ergebnis:

Eine große Zahl sehr gut informierter und ausgebildeter Studenten mit
guten Noten und kurzen Studienzeiten, die später sehr schnell
praxisorientierte Lösungen liefern können.  (wenn sie es schaffen, im
Internet einen aufzutreiben, der sie ihnen vordenkt).

Wohin führt das?

Es wird doch nur noch abgekupfert. Das Beste ist die neue Unsitte, aus
eigentlich längst geklärten Themen eine paper zu machen und es
werbewirksam zu publizieren:

Beitrag "Re: FPGA Lab: modulierbarer Signalgenerator, Universalzähler,."
Deswegen sollten wir uns angewöhnen, Rückfragen zu stellen, bevor wir
antworten. Unsere Rückfragen ermöglichen, die Ernsthaftigkeit der Frage
zu erkennen und so vermeiden wir es, und völlig lächerlich zu machen,
weil wir jede noch so bescheuerte Frage und Einsatz unserer Freizeit
mühsam beantworten, während andere sich lachend mit fremden Federn
schmücken.