REGEX Frage zur Ermittlung einer Zeichenkette

OP (Firma: Flk Consulting UG) #5433886
Lesenswert?
• ▲
▼
Hallo Zusammen,
ich stehe hier vor einem kleinem RegEx Problem.

Aufgabenstellung:
Wir führen eine Migration von Lotus-Notes nach SharePoint durch. Da in 
Lotus-Notes alles mögliche in ein Textfeld gepastet werden kann, stehen 
wir vor dem Problem, die Urls die sich in den Textbody befinden zu 
analysieren und entsprechend unserer Logik anzupassen.


Beim Export werden alle Dokumente die in so einem Textbody erwähnt 
werden als Attachment an den Datensatz angehangen. Diese Attachments 
werden von mir durch iteriert und ich versuche die Entsprechungen im 
Textbody zu finden und anzupassen.

Folgendes Problem tritt auf:

In einigen Namen tauchen spezielle Sonderzeichen auf, die ich in meinem 
RegEx mit "\S" berücksichtigen muss.

Jetzt tritt das Problem auf, dass der RegEx die Matches nicht immer 
eindeutig identifizieren kann und Treffer die einzeln stehen sollen zu 
einem Treffer zusammengezogen werden.

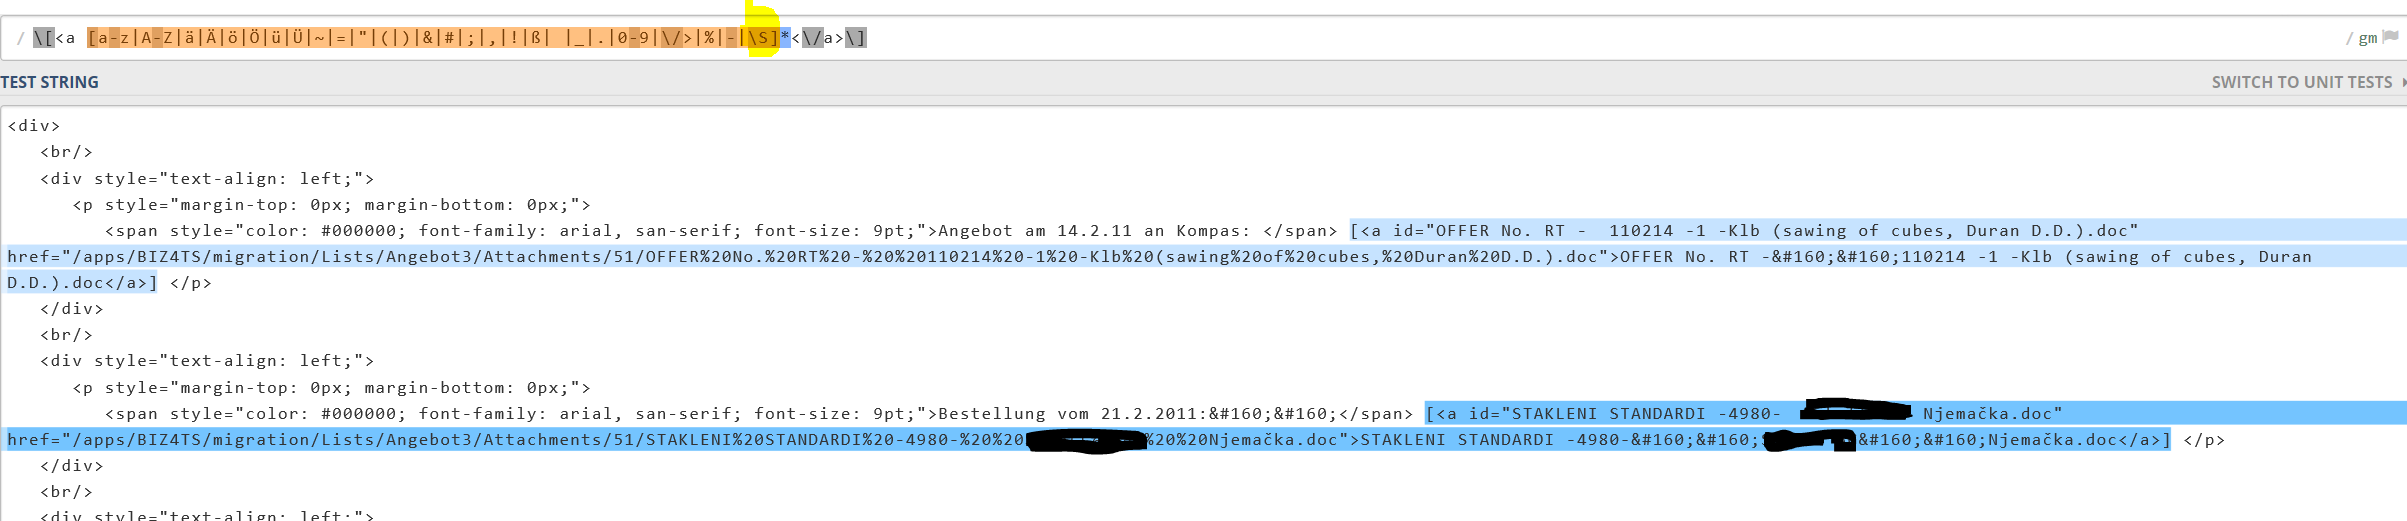
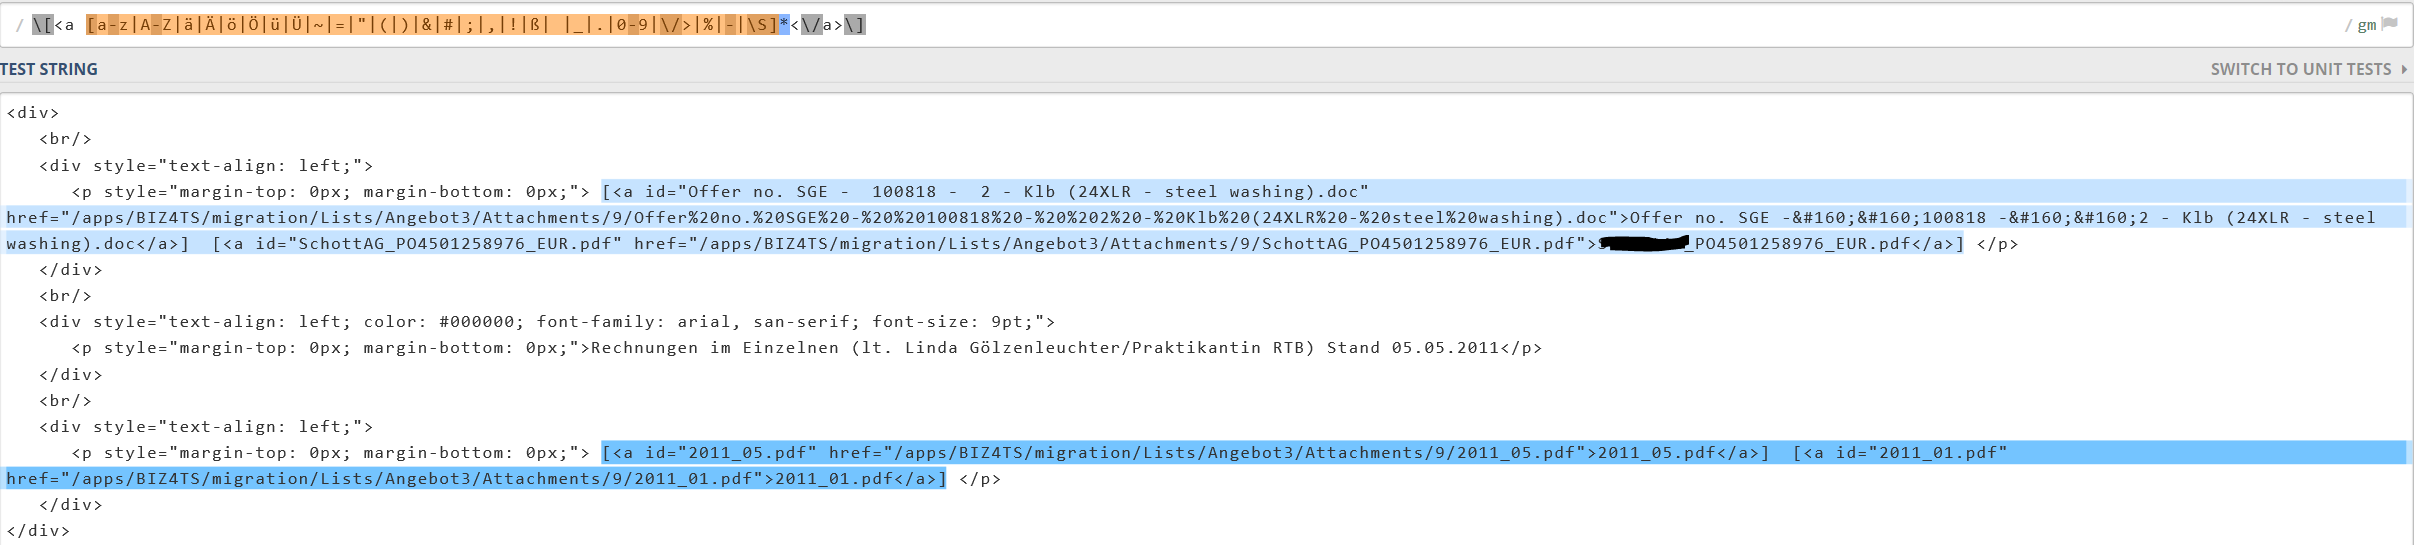
Ich habe versucht das Ganze an zwei Bilder zu verdeutlichen.

Bild1 zeigt das gewünschte Verhalten, es werden zwei Matches gefunden.
Bild2 zeigt das fehlerhafte Verhalten, es erden zwei Matches an Stelle 
von drei Matches gefunden.

Hier das von mir verwendete RegEx.
1
\[<a [a-z|A-Z|ä|Ä|ö|Ö|ü|Ü|~|=|"|(|)|&|#|;|,|!|ß| |_|.|0-9|\/>|%|-|\S]*<\/a>\]

Die zu ermittelnden Ausdrücke müßt Ihr aus den Bilder entnehmen, da ich 
diese hier nicht posten kann wegen Spam Meldung.

Wahrscheinlich kann man den Ausdruck noch kürzer formulieren, im Monent 
geht es mir nur darum den Fehler aus Bild2 zu eleminieren.

Gruß und Danke
Frank
Angehängte Dateien:
Gast #5433934
Lesenswert?
• ▲
▼
Nunja, du matchst zwischendrin ja auch so ziemlich alles, mit dem . 
eigentlich ganz alles, deshalb endet es nach dem </ a>] nicht.

Ich würde das eher so formulieren, um alle a tags in [] klammern zu 
finden:
1
\[<a(\s+[a-zA-Z\-][a-zA-Z0-9\-]*(=("[^"]*"|'[^']*'|[a-zA-Z0-9\-_]+)?)?)*\s*>([^<]*|<[^a]|<a[^ >])+</a\s*>\]
OP (Firma: Flk Consulting UG) #5433975
Lesenswert?
• ▲
▼
DPA schrieb:
> Ich würde das eher so formulieren, um alle a tags in [] klammern zu
> finden:\[<a(\s+[a-zA-Z\-][a-zA-Z0-9\-]*(=("[^"]*"|'[^']*'|[a-zA-Z0-9\-_] 
+)?)?)*\s*>([^<]*|<[^a]|<a[^
>>])+</a\s*>\]

Hallo,
funktioniert leider gar nicht.

ich verwende diese Seite "https://regex101.com";

Im Anhang mal die beiden Ausgangssituationen.

Gruß
Frank
Angehängte Dateien:
Gast #5434041
Lesenswert?
• ▲
▼
Frank L. schrieb:
> Ich nehme alles zurück, es klappt mit beiden Parsern.

Aber nur bei der letzten Version:
1
\[<a(\s+[a-zA-Z\-][a-zA-Z0-9\-]*(=("[^"]*"|'[^']*'|[a-zA-Z0-9\-_]+)?)?)*\s*>([^<]|<[^a]|<a[^ >])+<\/a\s*>\]

Das Problem war, dass der Abschnitt "([^<]*|<[^a]|<a[^ >])+" zu endlosem 
Backtracking führte, weil bei beliebig vielen [^<]* das <[^a] durch das 
+ ständig abwechselnd probiert wurden, womit die Zeit die das brauchte 
exponentiell wuchs. Durch das herausnehmen des ohnehin unnötigen * 
konnte ich das beheben "([^<]|<[^a]|<a[^ >])+".

Antwort schreiben

Hinweis: der ursprüngliche Beitrag ist mehr als 6 Monate alt. Bitte hier nur auf die ursprüngliche Frage antworten, für neue Fragen einen neuen Beitrag erstellen.

Formatierung
  • [c]C-Code[/c]
  • [code]Code in anderen Sprachen, ASCII-Zeichnungen[/code]
  • [math]Formel in LaTeX-Syntax[/math]
  • [[Titel]] – Link zu einem Artikel
  • Verweis auf einen anderen Beitrag: Rechtsklick auf dessen Beitrags-ID (#8078628), „Adresse kopieren“, in den Text einfügen

Mehr zur Formatierung

Längeren Sourcecode als Anhang, nicht in den Text. JPG nur für Fotos und Scans; Zeichnungen und Screenshots als PNG oder GIF. Siehe Bildformate.

Schon registriert? Anmelden

Wird nicht angezeigt. Wir schicken dir einen Link; sobald du damit bestätigst, erscheint dein Beitrag.

Mit dem Abschicken legst du einen kostenlosen Account an und erkennst die Nutzungsbedingungen und die Datenschutzerklärung an.