Accoustic echo cancellor

Gast #3808708
Hallo leute,

Ich muss mich für ein Projekt im Thema "Accoustic echo cancellor" 
einlesen. Ich habe zwar ein paar informationen gefunden, habe aber 
dennoch große Lücken wie das funktionieren soll.

Ich verwenden den LMS-Algorithmus, und dabei habe ich ein paar fragen 
dazu.

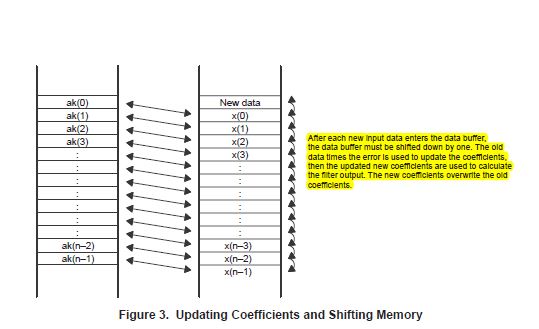
Wie viele Daten werden pro Zyklus neu in den Buffer gespeichert um 
daraus einen neuen filterkoeffizienten zu errechnen?
--> Bild

Wird immer nur ein neuer Filterkoeffizient errechnet oder geschieht das 
durch ganze Blöcke von neuen Koeffizienten?
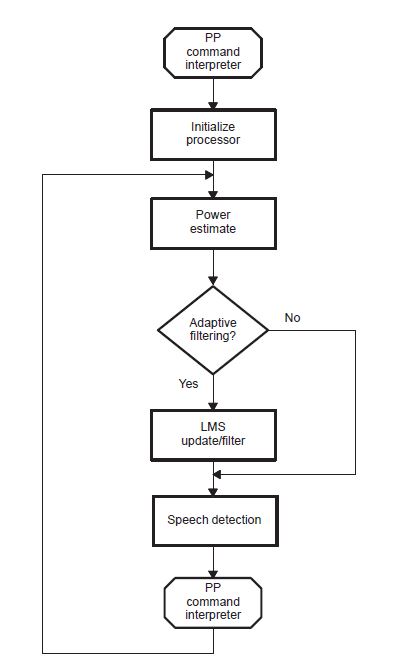
--> Bild

Ist es notwendig eine "Speech detection" einzubauen?
-> Habe immer verschiedene AEC-arten gesehen, bei manche war er dabei, 
bei manche nicht.

Und hat jemand nützliche Unterlagen zum einlesen?

Wäre super wenn ein bisschen mehr Klarheit bei diesem Thema wäre.

LG
Angehängte Dateien:
Admin Persönliche Seite #3812020
Christof schrieb:
> Wie viele Daten werden pro Zyklus neu in den Buffer gespeichert um
> daraus einen neuen filterkoeffizienten zu errechnen?

Ein Sample wird in den Buffer geschoben.

> Wird immer nur ein neuer Filterkoeffizient errechnet oder geschieht das
> durch ganze Blöcke von neuen Koeffizienten?

Es werden in jedem Schritt alle Filterkoeffizienten adaptiert. Was das 
ganze bei langen Filtern sehr rechenaufwendig macht, deshalb nimmt man 
einen reinen LMS nur wenn man sehr kurze Echopfade adaptieren muss. 
Schneller geht's mit einer Implementierung im Frequenzbereich.

> Ist es notwendig eine "Speech detection" einzubauen?

Eine double talk detection brauchst du immer wenn es in der Praxis 
funktionieren soll.

> Und hat jemand nützliche Unterlagen zum einlesen?

"Acoustic Echo Control – An Application of Very High Order Adaptive 
Filters" 
(http://kang.nt.e-technik.tu-darmstadt.de/nt/fileadmin/spg/lectures/af/ieee_sig_pro_mag_1999.pdf).

Ausführlicher und in Buchform: Hänsler, Schmidt, "Acoustic Echo and 
Noise Control: A Practical Approach", ISBN 0471453463
Gast #3812990
Eine Frage ist hätte ich noch, dass wo die Speech detection gemacht 
werden soll?

Im "Bild" ist nämlich die Speech detection erst am Schluss. Ich habe mir 
ganze Zeit gedacht, dass die Speech detection vor dem berechnen des 
Ausgangs gemacht werden soll, da auch von der Speech detection bestimmt 
wird ob dies überhaupt berechnet wird.

Oder wird es erst am Schluss gemacht und für den nächsten Zyklus 
bestimmt?

LG

Antwort schreiben

Eine eigene Frage? Dieser Thread ist über 12 Jahre alt. Stell sie in einem eigenen Thread – dort lesen mehr Leute mit, und sie wird öfter und schneller beantwortet.

Neuen Thread starten

Eine Lösung, Ergänzung oder Rückmeldung zu diesem Thread? Dann antworte hier.

Formatierung
  • [c]C-Code[/c]
  • [code]Code in anderen Sprachen, ASCII-Zeichnungen[/code]
  • [math]Formel in LaTeX-Syntax[/math]
  • [[Titel]] – Link zu einem Artikel
  • Verweis auf einen anderen Beitrag: Rechtsklick auf dessen Beitrags-ID (#8078628), „Adresse kopieren“, in den Text einfügen

Mehr zur Formatierung

Längeren Sourcecode als Anhang, nicht in den Text. JPG nur für Fotos und Scans; Zeichnungen und Screenshots als PNG oder GIF. Siehe Bildformate.

Schon registriert? Anmelden

Wird nicht angezeigt. Wir schicken dir einen Link; sobald du damit bestätigst, erscheint dein Beitrag.

Mit dem Abschicken legst du einen kostenlosen Account an und erkennst die Nutzungsbedingungen und die Datenschutzerklärung an.