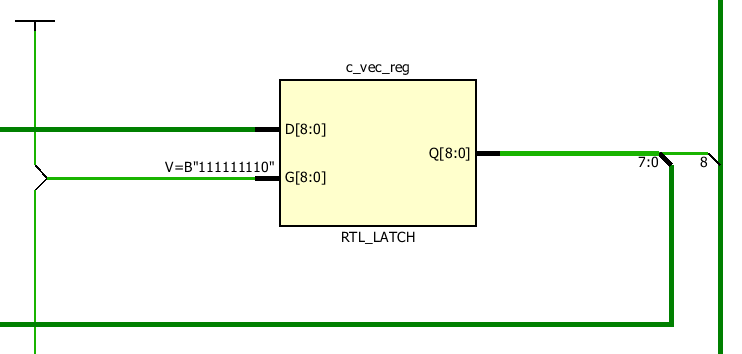
Wo ist der Unterschied? Einmal Latch, einmal nicht.

OP #4760034
Hallo, um etwas zu lernen probiere ich gerade Dinge aus. Da hab ich also 
einen Volladdierer:
1
s <= x xor y xor c_in;
2
c_out <= (x and y) or ((x xor y) and c_in);

So und daraus möchte ich einen 8Bit Addierer aufbauen. Ja, das kann man 
mit generate machen, aber will ich nicht.

Erste Lösung:
1
signal c_vec: std_logic_vector(8 downto 0):=(others => '0');
2
signal x_vec,y_vec,s_vec: std_logic_vector(7 downto 0):=(others => '0');
3
--c_vec ist eins länger weil eben Übertrag.
4
begin
5
process (x_vec,y_vec,c_vec) begin
6
  for I in 0 to 7 loop
7
    s_vec(I) <= x_vec(I) xor y_vec(I) xor c_vec(I);
8
    c_vec(I+1) <= (x_vec(I) and y_vec(I)) or ((x_vec(I) xor y_vec(I)) and c_vec(I));
9
  end loop;
10
end process;

Da macht die Synthese aus c_vec ein Latch.

Schreibe ich das ohne Loop aus:
1
s_vec(0) <= x_vec(0) xor y_vec(0) xor c_vec(0);
2
s_vec(1) <= x_vec(1) xor y_vec(1) xor c_vec(1);
3
s_vec(2) <= x_vec(2) xor y_vec(2) xor c_vec(2);
4
s_vec(3) <= x_vec(3) xor y_vec(3) xor c_vec(3);
5
s_vec(4) <= x_vec(4) xor y_vec(4) xor c_vec(4);
6
s_vec(5) <= x_vec(5) xor y_vec(5) xor c_vec(5);
7
s_vec(6) <= x_vec(6) xor y_vec(6) xor c_vec(6);
8
s_vec(7) <= x_vec(7) xor y_vec(7) xor c_vec(7);
9

10
c_vec(1) <= (x_vec(0) and y_vec(0)) or ((x_vec(0) xor y_vec(0)) and c_vec(0));
11
c_vec(2) <= (x_vec(1) and y_vec(1)) or ((x_vec(1) xor y_vec(1)) and c_vec(1));
12
c_vec(3) <= (x_vec(2) and y_vec(2)) or ((x_vec(2) xor y_vec(2)) and c_vec(2));
13
c_vec(4) <= (x_vec(3) and y_vec(3)) or ((x_vec(3) xor y_vec(3)) and c_vec(3));
14
c_vec(5) <= (x_vec(4) and y_vec(4)) or ((x_vec(4) xor y_vec(4)) and c_vec(4));
15
c_vec(6) <= (x_vec(5) and y_vec(5)) or ((x_vec(5) xor y_vec(5)) and c_vec(5));
16
c_vec(7) <= (x_vec(6) and y_vec(6)) or ((x_vec(6) xor y_vec(6)) and c_vec(6));
17
c_vec(8) <= (x_vec(7) and y_vec(7)) or ((x_vec(7) xor y_vec(7)) and c_vec(7));

Gibt es kein Latch.
Wo ist der Unterschied? Das ist doch alles kombinatorisch?

Edit:
Mit
1
fulladd: for I in 0 to 7 generate
2
  c_vec(I+1) <= (x_vec(I) and y_vec(I)) or ((x_vec(I) xor y_vec(I)) and c_vec(I));
3
  s_vec(I) <= x_vec(I) xor y_vec(I) xor c_vec(I);
4
end generate;
gibt es auch kein Latch. Also wieso gibt es bei der for loop im process 
eines?
OP #4760082
Ja, alle 9 Bits. Ist das aktuelle Vivado.

Aber:
Ich hatte das immer nur simuliert und das RTL Analysis > Schematic 
angeguckt. Wenn man das wirklich implementieren lässt, dann kommt das 
Gleiche bei raus. Immer 11 LUTs. Ist jedenfalls verwirrend ...
Moderator (Firma: Titel) Persönliche Seite #4760090
Gustl B. schrieb:
> Ich hatte das immer nur simuliert und das RTL Analysis > Schematic
> angeguckt.
Was sind dort das Enable-Signale (Latch-Signale) an diesen Latches?
Sind die statisch auf '1'/aktiv?

Dann dürfte das ein Automatismus sein, der erkennt, dass ein Signal auf 
sich selbst zugewiesen wird. Und daraus reflexartig ein Latch bastelt, 
das von nachfolgenden Optimierungsstufen auf normale Logik reduziert 
wird...
OP #4760788
Und es ghet weiter:
1
library IEEE;
2
use IEEE.STD_LOGIC_1164.ALL;
3

4
entity addierer is Port(
5
  x : in STD_LOGIC_VECTOR (7 downto 0);
6
  y : in STD_LOGIC_VECTOR (7 downto 0);
7
  s : out STD_LOGIC_VECTOR (8 downto 0));
8
end addierer;
9

10
architecture Behavioral of addierer is
11

12
signal c_vec: std_logic_vector(8 downto 0):=(others => '0');
13

14
begin
15

16
s(8) <= c_vec(8);
17

18
process (x,y,c_vec) begin
19
  for I in 0 to 7 loop
20
    c_vec(I+1) <= (x(I) and y(I)) or ((x(I) xor y(I)) and c_vec(I));
21
    s(I) <= x(I) xor y(I) xor c_vec(I);
22
  end loop;
23
end process;

Hier bleibt s(8) immer auf unknown 'U'. Steckt man die Zeile
s(8) <= c_vec(8);
aber mit in die loop, dann sieht es in der Simulation korrekt aus. 
Wieso?

Wieder: Wenn man das als generate schreibt
1
s(8) <= c_vec(8);
2
fulladd: for I in 0 to 7 generate
3
  c_vec(I+1) <= (x(I) and y(I)) or ((x(I) xor y(I)) and c_vec(I));
4
  s(I) <= x(I) xor y(I) xor c_vec(I);
5
end generate;

dann passt es auch so in der Simulation. Ja, es kommt wieder identische 
Hardware raus, aber ich möchte verstehen wieso sich die Simulation so 
seltsam verhält.
Moderator (Firma: Titel) Persönliche Seite #4761135
Gustl B. schrieb:
> Funktioniert auch wie gewünscht in der Simulation.
> Aber wieso muss diese Zeile s(8) <= c_vec(8); überhaupt in den Process?
Probier mal das hier noch aus:
1
process (c_vec) begin
2
  s(8) <= c_vec(8);
3
end process;
4

5
process (x,y,c_vec) begin
6
  for I in 0 to 7 loop
7
    c_vec(I+1) <= (x(I) and y(I)) or ((x(I) xor y(I)) and c_vec(I));
8
    s(I) <= x(I) xor y(I) xor c_vec(I);
9
  end loop;
10
end process;
Das ist das, was der Simulator aus der originalen nebenläufigen 
Beschreibung macht. Und jetzt sieht man, dass da möglicherweise multiple 
Treiber auftreten könnten (wenn man mal nicht auf den Bereich der 
Laufvariable achtet).

Und dann weils grad so schön ist, probier das noch aus:
1
s(8) <= c_vec(8) after 1 ns;
2

3
process (x,y,c_vec) begin
4
  for I in 0 to 7 loop
5
    c_vec(I+1) <= (x(I) and y(I)) or ((x(I) xor y(I)) and c_vec(I));
6
    s(I) <= x(I) xor y(I) xor c_vec(I);
7
  end loop;
8
end process;

Bin gespannt... ;-)

Gustl B. schrieb:
> Hier bleibt s(8) immer auf unknown 'U'.
'U' ist nicht Unknown, sondern Uninitialized.
https://www.csee.umbc.edu/portal/help/VHDL/misc.html
Moderator (Firma: Titel) Persönliche Seite #4761769
Und jetzt noch einer:   ;-)
1
process (c_vec) begin
2
  s(8) <= c_vec(8);
3
end process;
4

5
process (x,y,c_vec) begin
6
  for I in 0 to 7 loop
7
    c_vec(I+1) <= (x(I) and y(I)) or ((x(I) xor y(I)) and c_vec(I));
8
  end loop;
9
  s(0) <= x(0) xor y(0) xor c_vec(0);
10
  s(1) <= x(1) xor y(1) xor c_vec(1);
11
  s(2) <= x(2) xor y(2) xor c_vec(2);
12
  s(3) <= x(3) xor y(3) xor c_vec(3);
13
  s(4) <= x(4) xor y(4) xor c_vec(4);
14
  s(5) <= x(5) xor y(5) xor c_vec(5);
15
  s(6) <= x(6) xor y(6) xor c_vec(6);
16
  s(7) <= x(7) xor y(7) xor c_vec(7);
17
end process;
Moderator (Firma: Titel) Persönliche Seite #4762373
Gustl B. schrieb:
> Aber was haben wir da jetzt gelernt?
Es gibt im Simulator ein Problem mit einer vermeintlichen Multisource, 
wenn dem Vektor aus 2 Prozessen (oder eben 1 Prozess und 1 nebenläufigen 
Zuweisung) zugewiesen wird. Wenn man sich das genau anschaut, ist dieses 
Verhalten sogar "genormt"...  :-/

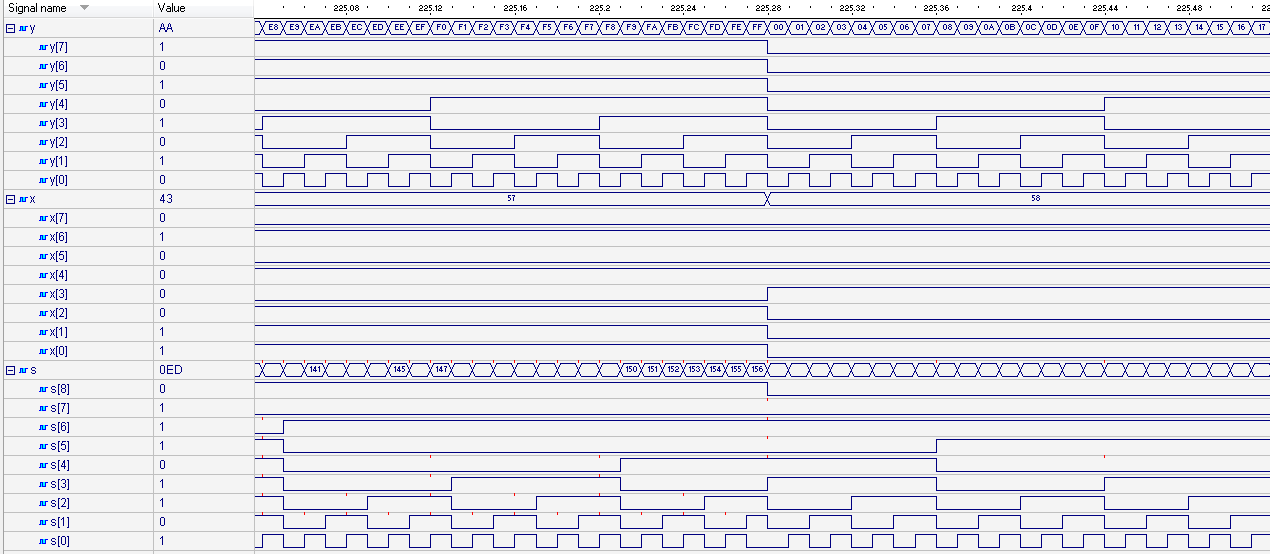
Mit einem lokalen Signal zum Auftrennen dieser Zuweisung gehts dann 
wieder (siehe Screenshot):
1
library IEEE;
2
use IEEE.STD_LOGIC_1164.ALL;
3

4
entity addierer is Port(
5
  x : in STD_LOGIC_VECTOR (7 downto 0);
6
  y : in STD_LOGIC_VECTOR (7 downto 0);
7
  s : out STD_LOGIC_VECTOR (8 downto 0));
8
end addierer;
9

10
architecture Behavioral of addierer is
11
signal c_vec: std_logic_vector(8 downto 0):=(others => '0');
12
signal s_vec: std_logic_vector(7 downto 0):=(others => '0');
13
begin
14

15
s(8)          <= c_vec(8); 
16
s(7 downto 0) <= s_vec;
17

18
process (x,y,c_vec) begin
19
  for I in 0 to 7 loop
20
    c_vec(I+1) <= (x(I) and y(I)) or ((x(I) xor y(I)) and c_vec(I));
21
    s_vec(I) <= x(I) xor y(I) xor c_vec(I);
22
  end loop;
23
end process;
24

25
end Behavioral;

Die Simulatoren Active-HDL und ISIM verhalten sich übrigens gleich wie 
der Vivado-Simulator.
Angehängte Dateien:
OP #4762678
HM komisch. Ich hätte erwartet, dass ein std_logic_vector von der 
Simulation nicht als ein Stück berechnet wird sondern als einzelne 
std_logic. Hier wird das ja nicht als Speicher sondern nur als Kabelbaum 
verwendet.
(Firma: fritzler-avr.de) #4763823
Nochmal zu den Latches:
Die Zuweisungen in Prozessen gehen der Reihe nach, Zeile für Zeile.
Generate baut dir eine normale Logikwolke.
Wenn eine Logikwolke gewollt ist -> generate.

Beim Prozess gibt es einen latch, weil c_vec(0) Im prozess nie 
beschrieben wird, aber ausgelesen.
Daher muss er den Vektor Zwischenspeichern -> Latch.
Die Synthese erkennt aaber, dass das Murks ist und wirft die Lacthes 
wieder raus.

Also mach mal:
1
signal c_vec: std_logic_vector(8 downto 0):=(others => '0');
2
signal x_vec,y_vec,s_vec: std_logic_vector(7 downto 0):=(others => '0');
3
--c_vec ist eins länger weil eben Übertrag.
4
begin
5
process (x_vec,y_vec,c_vec) begin
6
  c_vec(0) <= '0';
7
  for I in 0 to 7 loop
8
    s_vec(I) <= x_vec(I) xor y_vec(I) xor c_vec(I);
9
    c_vec(I+1) <= (x_vec(I) and y_vec(I)) or ((x_vec(I) xor y_vec(I)) and c_vec(I));
10
  end loop;
11
end process;

Ich bin gespannt,
OP #4764406
Funktioniert und auch das funktioniert:
1
library IEEE;
2
use IEEE.STD_LOGIC_1164.ALL;
3

4
entity addierer is Port(
5
  x : in STD_LOGIC_VECTOR (7 downto 0);
6
  y : in STD_LOGIC_VECTOR (7 downto 0);
7
  s : out STD_LOGIC_VECTOR (8 downto 0));
8
end addierer;
9

10
architecture Behavioral of addierer is
11

12
signal c_vec: std_logic_vector(8 downto 0):=(others => '0');
13

14
begin
15

16
process (x,y,c_vec) begin
17
   s(8) <= c_vec(8);
18
   for I in 0 to 7 loop
19
      s(I) <= x(I) xor y(I) xor c_vec(I);
20
      c_vec(I+1) <= (x(I) and y(I)) or ((x(I) xor y(I)) and c_vec(I));
21
   end loop;
22
end process;
23

24
end Behavioral;

Wobei s(8) <= c_vec(8); wieder im Process stehen muss. Ich finde das 
seltsam weil in der loop werden nur s(7 downto 0) berechnet. Wieso 
berechnet die Simulation s(8) nicht komplett eigenständig? Also gerne 
einen Simulationsschritt später, dann hat sich c_vec(8) geändert und 
somit ändert sich auch s(8). Irgendwie ist das unlogisch ausser man sagt 
dass die Simulation std_logic_vector immer als ganzes berechnet.
Eigentlich soll die Simulation doch das zeigen was dann auch das FPGA 
macht.
Die Post-Synthesis Simulation zeigt natürlich immer das richtige 
Verhalten.
OP #4764433
Beispiel:
1
library IEEE;
2
use IEEE.STD_LOGIC_1164.ALL;
3

4
entity addierer is Port(
5
  x : in STD_LOGIC_VECTOR (7 downto 0);
6
  y : in STD_LOGIC_VECTOR (7 downto 0);
7
  s : out STD_LOGIC_VECTOR (8 downto 0));
8
end addierer;
9

10
architecture Behavioral of addierer is
11

12
signal c_vec: std_logic_vector(8 downto 0):=(others => '0');
13

14
begin
15

16
s(8) <= c_vec(8);
17

18
process (x,y,c_vec) begin
19
   for I in 0 to 7 loop
20
      s(I) <= x(I) xor y(I) xor c_vec(I);
21
      c_vec(I+1) <= (x(I) and y(I)) or ((x(I) xor y(I)) and c_vec(I));
22
   end loop;
23
end process;
24

25
end Behavioral;

Na selbst wenn das im Process nacheinander berechnet wird, dann sollte 
doch nach dem Durchlauf oder mehreren Durchläufen am Ende c_vec(8) 
stabil sein. Und da s(8) nicht im process auftaucht sollte das doch dann 
den Wert von c_vec(8) bekommen. Aber s(8) bleibt auf 'U'. Das finde ich 
unlogisch.

Antwort schreiben

Eine eigene Frage? Dieser Thread ist über 10 Jahre alt. Stell sie in einem eigenen Thread – dort lesen mehr Leute mit, und sie wird öfter und schneller beantwortet.

Neuen Thread starten

Eine Lösung, Ergänzung oder Rückmeldung zu diesem Thread? Dann antworte hier.

Formatierung
  • [c]C-Code[/c]
  • [vhdl]VHDL-Code[/vhdl]
  • [code]Code in anderen Sprachen, ASCII-Zeichnungen[/code]
  • [math]Formel in LaTeX-Syntax[/math]
  • [[Titel]] – Link zu einem Artikel
  • Verweis auf einen anderen Beitrag: Rechtsklick auf dessen Beitrags-ID (#8078628), „Adresse kopieren“, in den Text einfügen

Mehr zur Formatierung

Längeren Sourcecode als Anhang, nicht in den Text. JPG nur für Fotos und Scans; Zeichnungen und Screenshots als PNG oder GIF. Siehe Bildformate.

Schon registriert? Anmelden

Wird nicht angezeigt. Wir schicken dir einen Link; sobald du damit bestätigst, erscheint dein Beitrag.

Mit dem Abschicken legst du einen kostenlosen Account an und erkennst die Nutzungsbedingungen und die Datenschutzerklärung an.