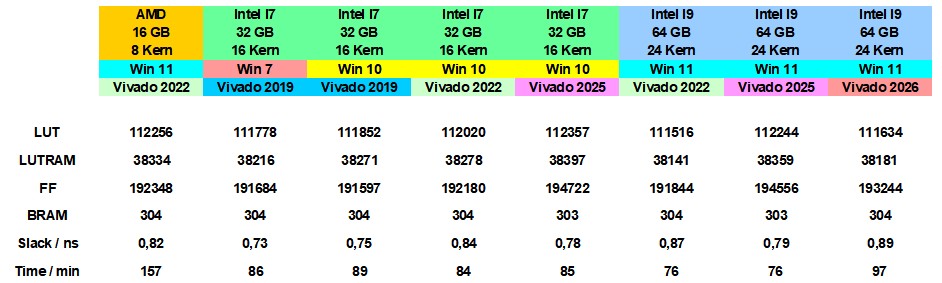
3 Vivados x 3 Computer x 3 Betriebssysteme = Erkenntnis des Tages (s.u.).
Ich habe meine alte Workstation von Win7 auf Win10 gebracht (Win 11 wollte nicht installieren) und dabei die Gegenheit genutzt, das Syntheseergebnis von Vivado zu testen und mit meiner neuen Workstation sowie meinem Reise-PC zu vergleichen.
Aufgeführt sind nur die Veränderungen. MULs und IOs sind erwartungsgemäß gleich. Es ist immer dasselbe Design meines Synthesizers in der Ausbaustufe für einen Artix 100 - FPGA. Hat alles drin außer Transceivern. Nutzt 8+2 Taktdomänen / CLK-Regionen und damit einiges an SERDES, MCM und PLL. Es wurde von den Sourcen ausgehend synthetisiert, d.h. alle Cores mussten gebaut werden. DCPs und Synth-Verzeichnisse wurden gelöscht.
Offenbar ist Win10 langsamer, als Win7 oder es laufen mehr Prozesse im Hintergrund. Das noch installierte 2019 braucht nicht nur länger, sondern bringt auch ein schlechteres Ergebnis. Danach habe ich zum Vergleich Vivado 2022 installiert (geht nicht unter Win 7) und zusätzlich auch Vivado 2025, die ich auf der neuen Workstation nutze. Interessant, was jeweils 3 Jahre Vivado-Fortschritt ausmachen (oder auch nicht ausmachen).
Es scheint zu stimmen, was man öfters liest, daß alte Vivados kleinere files produzieren. Auch ist das Syntheseergebnis von dem Rechner an sich abhängig. Gleiches Vivado auf anderem Rechner ergibt ein anderes Ergebnis. Wurde mir auch schon durch einen FAE bestätigt. Da spielen sogar parallel laufende Programme eine Rolle, weil die Synthesegeschwindigkeiten auf den Cores variieren und damit deren Beitrag zum Gesamtergebnis.
Meine Interpretation ist, dass mit Rücksicht auf schnellere Synthesen weniger gut optimiert wird, um mit den größeren Designs zurecht zukommen.
Besonders eklatant ist es beim Vergleich mit der neuen Workstation: Mehr Cores, mehr Geschwindigkeit- wenngleich es nicht so sehr viel besser ist, wie die Benchmarks versprechen. Eigentlich hätte ich noch mehr Tempo erwartet. Der Rechner ist in der Gesamtperformance beim z.B. Rendern grob doppelt so schnell.
Die interessanteste Zahl findet sich unten rechts! Da fragt man sich, wozu man überhaupt eine moderne workstation nutzen muss! Dazu schreibt XI, dass man "Einschränkungen bei der Multitasking-Fähigkeit" vorgenommen hat. Wer seinen Computer voll nutzen will, muss also die 1.200,- auf den Tisch legen und das jährlich!
Zusammen mit der Einschränkung, dass nur 1 debug core genutzt werden kann, fällt die 2026 erstmal für mich weg!
Interessant an der ist übrigens auch, daß sie wieder ein BRAM mehr benutzt, während die 2025 es irgendwie schafft, eines wegzusparen. Die gewählte Strategie ist jedesmal die gleiche gewesen (Perf OPT) , aber intern dürfte es da sicher Unterschiede geben, wasXI draus macht.
Würde mich mal interessieren, wie das bei anderen aussieht.
Die zeitaufwendigsten Aufgaben sind kaum parallelisierbar. Daher profitiert die Software mehr von einer hohen single-core Performance, als von vielen cores.
Und viel RAM hilft.
Ich vermute, der erste Rechner in der Tabelle wurde nicht von der CPU-Kernanzahl, sondern eher von den nur 16 GB RAM ausgebremst.
Übrigens ist die Vivado Performance unter Linux deutlich höher, als unter Windows.
Auf dem gleichen Rechner mit 256 GB RAM und CPU mit hoher Single-Core Performance lief ein Projekt für einen großen Ultrascale+ unter Linux in einem Viertel (!) der Zeit durch, wie unter Windows 11.
Win11: 8h, Linux: 2h
Bei uns laufen die Designs deutlich schneller durch Vivado, wenn sie auf einem der Teamcity Agents auf Windows Server bauen. Die VMs laufen auf Proxmox und haben auch nur 16GB RAM zugewiesen und ich glaube 4 Cores. Woran genau das liegt, hab ich noch nicht rausgefunden. Vielleicht sind unsere verwalteten Desktops einfach nur sehr lahm ^^
Vielleicht sind unsere verwalteten Desktops einfach nur sehr lahm
Das mit Sicherheit. Gerade Windows ist aufs Gamen ausgelegt. Da ist viel Multimediamist drin, der bremst, daher wollte ich da ja immer von weg. Gleichwohl sind viele Firmen voll auf der windows-Schiene. Es hat sich einfach festgesetzt. Da muss ich dann eben mitgehen.
Dazu gab es eine Aussage eines FAEs auf einer Tagung: PCs mit Vivado sollte wenigstens 32GB haben und wenn sie Versal-Chips bauen sollen, dann eher 64GB. Es gibt auch Spezialisten, die die gesamte XI-Installation auf einer RAM-DISK haben und dort laufen lassen. Speicher ist ja billig.
Ein Nachtrag noch von mir:
Wenn man nur Cores baut, zieht sich das weiter auseinander. Die neue Maschine mit dem I9 und den 24 Cores braucht nur noch 60% der Zeit, wie der I7 mit den 16. Ob es am RAM oder am Tempo liegt kann ich nicht sagen. Der neue hat z.B. auch sehr schnelle SSDs.
Wo man es auch merkt: 2 Vivados parallel betreiben und von den gleichen geänderten Sourcen ausgehend, 2 verschiedene designs bauen lassen, die unterschiedliche Testfunktionen und Debug Cores drin haben, damit es jeweils noch ins FPGA passt und man parallel testen lassen kann.
Und natürlich, wenn man 2 FPGAs gleichzeitig umbauen muss, weil die hintereinander hängen. Da schlägt dann der Single-Core-Flaschenhals nur einmal zu.
Für mich sind die Ergebnisse aktuell nicht nachvollziehbar. Mein Verständnis ist, dass die selbe Vivado Version unabhängig von dem Betriebssystem das selbe Bitstream File erzeugen muss.
Das ist fester Besteandteil unseres Entwicklungsprozesses und wird mit jeder Firmware Release auch geprüft, d.h. ich baue es auf meinem System (aktuell noch Win 10) und ein Kollege auf seinem (Win 11), anschließend wird eine Checksum über die Bin Files gebildet und abgeglichen
Gebaut wird bei uns von Scratch aus einem Tcl Script, welches u.a. das Vivado Projekt erstellt.
Wenn bei Dir der Ressourcenverbrauch also unterschiedlich ist, kann das verschiedene Gründe haben:
Vivado Version unterscheidet sich (also beispielsweise mal mit oder Ohne Update)
Vivado Projekt unterscheidet sich (unterschiedliche Einstellungen)
Vivado bezieht vorherige Build runs mit ein und kommt dadurch zu einem abweichenden Ergebnis.
Wenn Du Vergleiche anstellen willst, solltest du m.E. erst einmal innerhalb von einer Vivado Version auf verschiedenen Plattformen das selbe Bitstream File erzeugen können.
erst einmal innerhalb von einer Vivado Version auf verschiedenen
Plattformen das selbe Bitstream File erzeugen können.
Wenn alles gleich und konstant ist und man wirklich von Null startet, passiert das in aller Regel auch. Es ist allerdings auch dann nicht 100% gesichert. Besonders bei der Implementierung kann es zu Unterschieden kommen, wie sowohl von Xilinx selber, als auch durch Distri-FAEs bestätigt wurde. Das Problem kam bei einem Kunden hoch, der diesen Reproduktionsanspruch hatte und wo diesbezüglich intensiv nachgefragt und geforscht wurde. Auch durch Tests lässt und liess sich das bestätigen. Spätestens bei einem anderen Rechner kann das auftreten. Die Gründe liegen unter anderem in der unterschiedlichen Fertigstellung von Cores, deren DCPs sowie dem Multithreading.
Die Hauptursache an sich ist der Versuch von Vivado, Rechen- und Implementierungszeit zu sparen. Daher können bei jedem einzelnen Rückgriff auf vorgefertige Zwischenlösungen neue Randbedingungen ins Design kommen, welche das Routing-Ergebnis beeinflussen, selbst dann, wenn dieselben Strategien appliziert werden. Im Prinzip ist es Dasselbe, wie bei einem PCB-Layout, wenn man an anderer Stelle anfängt, oder einen vorgefertigten Block einsetzt. Die geroutete Schaltung kann praktisch Dasselbe zieht aber geometrisch etwas anders aus. Wenn dann unterschiedliche Blocks = Core-Ergebnisse infolge unterschiedlicher Prozessor-Last oder Multithreading zu anderen Zeiten fertig werden, hat man den ersten denkbaren Einfluss der Rechenpower.
Hinzu kommt noch, daß Vivado inzwischen machine learning einsetzt. Wo und wie das wirkt, wird sowohl von Xilinx selber, als auch den FAEs nur oberflächlich kommuniziert. Man kann davon ausgehen, dass sich das tool irgendwo irgendwelche Dinge merkt, oder zumindest probiert, es sich zu merken. Sofern das alles im Projektverzeichnis bleibt, müsste sich dieser Aspekt durch vollständiges Löschen eliminieren lassen. Bei besagten Test wurde das Projekt komplett gelöscht und jeweils per Script neu aufgesetzt. Dennoch gab es Unterschiede, zumindest bei unterschiedlichen Rechnern - obwohl die ML-Versionen gerade erst frisch rausgekommen.
Der Punkt ist daher aus meiner Sicht offen. Es bleibt in jedem Fall der Aspekt der Ausführungzeit und eine mögliche Rücksichtnahme der Software auf die jeweils verstrichene Zeit bei der Implementierung:
Soweit ich das überschaue, hat die Prozessorlast auf schon einer CPU (unter Ausschluss des Multithreadings) zumindest dann noch einen möglichen Einfluss, wenn bei der Implementierung durch die Optimierungsansätze jeweils an unterschiedlichen Stellen probiert wird, ausreichend timing budget zu schaffen. Das ist bei praktisch allen solchen Optimierungen der Fall, sei es bei Schaltungssimulation, FEM oder geometrischen Optimierungen durch Annealing-Verfahren:
Man geht von Block zu Block und optimiert die Struktur Stück für Stück und schafft etwas budget, bevor man zum nächsten hüpft. Das ist effektiver, als immer nur ein Element zu rücken und dann wieder global in das System zu schauen. Dabei gibt es ein Hauptkriterium: Die zuletzt gewonnene Güte im Bezug auf die dafür benötigte Zeit. Da solche Optimierungen in eine Sättigung laufen, springt man logischerweise bei einem beginnenden Abflachen lieber in die nächste Zelle, statt sich weiter in der ersten abzurackern.
Um die Strategien, wie man abschätzen kann, ab wann man springt, neu sucht, die zu optimierende Zelle schätzt und wie lang man wo investiert, ranken sich Doktorarbeiten.
An der Stelle wird die Prozessorlast definitiv zu anderen Zeitpunkten führen, an denen ausgesprungen wird. Sobald nämlich die Software mit einer lokalen Optimierung zufrieden ist, z.B. man rutscht eine Kombinatorik ein FF nach vorn oder hinten und schätzt das budgt, könnte sie weiterlaufen oder eben auch nicht. Wenn da die Synthesezeit eine Rolle spielt (und das tut sie!) dann könnte im Einzelfall ein Hüpfen bei einem etwas schlechten Zwischenschritt erfolgen.
Was man in solchen Systemen auch tut, ist ein lokaler Mehrafachansatz: D.h. man wirft eine Aufgabe 2 oder mehrmals mit leicht veränderten Kriterien in eine pipeline und misst die Ergebnisse, wobei man sich das Beste schnappt und per Funktion wieder hochreicht. Solche Dinge laufen als Iteration oder auch Rekursion. Spätestens hierbei spielen Vorgaben von Ausführungszeiten eine Rolle, wenn z.B. nicht 4 sondern nur 3 Ansätze verfolgt werden.
Inwieweit Xilinx sowas nutzt oder Ähnliches wirkt, kann ich nicht sagen. Ich habe aber solche Systeme schon entworfen. Ein wesentlicher Ansatz dabei sind oftmals zufällig gewählte Startwerte für Gewichtungen, mit denen die "Wichtigkeit" eines Aspekts in die Entscheidung einfließt. So wie bei neuronalen Netzen braucht es immer eine Art Gütefunktion, die eine endliche Zahl von Parametern hat und die mit minimal unterschiedlichen Werten belegt werden, um zu varieren.
Auch diese Startwerte - sogeannte seed values - können eine Rolle spielen, wenn sie z.B. aus Zufallsgeneratoren gewonnen werden, die irgendwie von der Rechnerzeit- oder dem aktuellen Rechnerzustand abhängen. Gerade in früheren Zeiten war das sehr modern, das zu nutzen. Heute geht man eher zu deterministischen Werten über die reproduzierbare Scheinzufallswerte liefern, die gezielte Wertebereiche abdecken, d.h. die Variationsansätze sind willkürlicher.
In jedem Fall begründet das schon einmal, warum unterschiedliche Versionen zu anderen Ergebnissen führen, weil sich nämlich die Strategien bei Synthese und Implementierung mit jeder Vivado-Version ändern dürften, d.h es gibt andere Voreinstellungen für die Gewichtungen.
Ungeachtet der Gründe halte ich die gesamte Frage für untergordnet.
Es gibt aus meiner Sicht keinen Vorteil, wenn man ein Design nochmals identisch implementieren kann, weil das praktisch nicht nötigt ist, es sei denn man verschlampt das BIT-File und muss weitere boards programmieren.
Ansonsten sind neue Bitfiles immer das Ergebnis des Hinzügens einer Funktion und da bei sicherheitskritischen Anwendungen jedes Exemplar eines PCBs getestet werden muss und die dafür nötigen Funktionen enthalten sein müssen, ist es Wurscht. Man darf nicht vergessen, dass jeder Synthesereport nur ein virtuelles Ergebnis liefert, was das budget angeht und jeder einzelne FPGA und jedes PCB anders reagiert und eben Fehler enthalten kann.
D.h. da liegt der Hund begraben.
Du machst hier in dem Thread, zumindest heißt er so, einen Vergleich mit Vivado auf verschiedenen Computern mit verschiedenen Betriebssystemen.
Was ist denn so ein Vergleich wert wenn das was man vergleichen möchte nicht vergleichbar ist? Es ist wirklich nicht schwer ein Projekt so aufzusetzen, dass bei jeder Synthese des identische Bitstream rauskommt.
Gleiche Quellen und gleiche Einstellungen und Version.
Sowas taugt dann auch um den Einfluss von Hardware und Betriebssystem zu beurteilen.
einen Vergleich mit Vivado auf verschiedenen Computern mit verschiedenen
Betriebssystemen.
Richtig. Es ging dabei um die Wirkung der offensichtlichen Unterschiede. Dass es auch versteckte zufällige Effekte gibt, die das verwässern, ist nicht unrichtig, ändert die Aussagen aber nur minimal:
Was ist denn so ein Vergleich wert wenn das was man vergleichen möchte
nicht vergleichbar ist?
Es handelt sich wie gesagt um immer dasselbe Design, das in der Regel auch immer zum selben Ergebnis führt, wenn auch zu anderen Ausführungszeiten. Die Unterschiede, die durch eventuelle Einflüsse auf demselben Rechner (ausnahmsweise) zustandekommen (könnten), sind marginal: Man bekommt selbstredend nicht bei einem Druchlauf ein gewaltiges timing budget und ein anderes mal nicht, nur weil der Rechner etwas anders konfiguriert und belastet ist. Die Unterschiede in den Tabellen sind also zwar exemplarisch - aber durchaus systematisch. Man muss eben das richtige miteinander vergleichen, z.B. 2 Vivados bei ansonsten gleichen Parametern wie "Rechner" und "OS".
Was ich vor allem zeigen wollte, ist der Umstand, dass sich ein sehr viel schnellerer Rechner nicht so sehr auswirkt und ...
... dass die Einschränkungen, die XI bei der neuen 2026er vorgenommen hat, durchaus eine Rolle spielen. Das hätte ich eventuell noch etwas deutlicher rausarbeiten können und hole das nun nach:
Ich möchte mich nicht zu weit aus dem Fesnter zu lehnen, schlussfolgere aber, daß diese Einschränkungen in der 2026er ziemlich massiv auf die Synthesezeit gehen, weil es auf dem schnelleren Rechner deutlich langsamer geht, als auf dem eigentlich Langsameren. Ich sehe da konkret 25% mehr Synthesezeit. Und das liegt eben an der Version. Die anderen Versionen laufen auf dem schnelleren Rechner schneller und die Änderungen sind auch plausibel.
Was ich noch nicht 100%ig sehe ist, woher die Mehrzeit konkret kommt. Da werde ich gfs nochmal genauer draufschauen. Ich vermute die mangelnde Parallelität: Gerade das Bauen der Cores profitiert von vielen Kernen. Wenn XI dies ausbremst hat man mit der 2026er die A-Karte!
Es gibt aus meiner Sicht keinen Vorteil, wenn man ein Design nochmals
identisch implementieren kann, weil das praktisch nicht nötigt ist, es
sei denn man verschlampt das BIT-File und muss weitere boards
programmieren.
Das wäre aus meiner Sicht sehr fatal.
Nimm Dein Beispiel aus dem anderen Thread, in dem sich das FPGA verrechnet. Wenn man bei jedem Bauen eines identischen Codes und Projektes ein unterschiedliches Bitstream bekommen würde, lässt sich der Fehler nicht einmal reproduzieren.
Auch sonst ist eine der ersten Fragen, wenn ein Fehler gefunden wird, ob der Code zum Bitstream passt.
Es ist schon häufig vorgekommen, dass ein Entwickler nicht den Stand aus dem Repo baut, sondern einen "Dirty" Stand auf seiner Platte. Wie möchtest Du denn nachweisen, dass ein Bitstream zu einem Code Stand passt, wenn der Build Prozess nicht reproduzierbar ist?
Wir haben mit einem sauberen scriptbasierten Buildprozess bisher keine Abweichungen wahrgenommen, das wäre aber wahrscheinlich ein Punkt, der sogar einen Tool/Herstellerwechsel erfordern würde
Zu einem ordentlichen Integrationsprozess gehört IMMER eine Versionierung des Codes. Sowohl das BIT-File, als auch das ROM-File sind einem konkreten Erstelldatum zugeordnet, enthalten standardmässig ein Datum sowie eine Versionsnummer - zumindest in SW abgebildet. Diese Werte werden bei jedem build sinnvollerweise automatisch gebildet, versioniert, in den Code sowie das file eingebaut und auch in z.B. Doxy hinterlegt. Z.B. bildet man über alle sourcen und constraints, sowie irgendwie geartete Scripte, die Einfluss nehmen, samt Datum eine Quersumme.
Nicht zuletzt gehört ein solches BIT-file, wie auch das Prom-File mitsamt der Quellen in eine Datenbank eingecheckt.
Von daher sehe ich nach wie vor nicht die Notwendigkeit, nochmal dasselbe file zu erzeugen, es sei denn, wie gesagt, man hat es verbummelt, es einzuchecken. Richtigerweise wird man dann das neue einchecken und es entsprechend vermerken.
Wenn es daraum ginge, zwei HW mit einander zu vergleichen (um z.B. o.g. Spezialfehler zu detektieren), wird man immer dasselbe BIT-File draufladen, egal ob alt oder neu erzeugt. Von daher macht es also keinen Unterschied.
Über zwei künstlich erzeugte identische Versionen hinweg zu testen, sehe ich nicht, es sei denn, man möchte in der Tat Xilinx nach weisen, dass Zufälligkeiten in den build-Prozessen zu Abeichungen führen, welche dann zu einer Nichtfunktion führen. Um das zu erzielen, müsste man gfs. das Datum der Erstellung fälschen, oder eben Teile eines automatisierten build-Prozesses umgehen, indem man die Versionierung blockt.
In der Praxis sehe ich das nicht, weil jeder FPGA-BIT-Stream, der ausgeliefert werden soll, getestet wird / werden muss! Im Zuge der Integration hat man ja sowohl im FPGA selber, als auch dem PCB - und nicht zuletzt der SW / FW entsprechende Methoden integriert, um das System funktional zu testen. Damit werden allemöglichen Fehler erschlagen - sofern man es richtig anstellt.
Der von dir skizzierte Fall, dass ein Entwickler irgendwas aus falschen Sourcen produziert, ist daher genau dann eben kein Problem, wenn man die gelieferte Software als das ansieht, was sie ist: Eine neue Version. Die muss eben entsprechend behandelt werden.
Hä?
Du machst hier in dem Thread, zumindest heißt er so, einen Vergleich mit
Vivado auf verschiedenen Computern mit verschiedenen Betriebssystemen.
Was ist denn so ein Vergleich wert wenn das was man vergleichen möchte
nicht vergleichbar ist? Es ist wirklich nicht schwer ein Projekt so
aufzusetzen, dass bei jeder Synthese des identische Bitstream rauskommt.
Gleiche Quellen und gleiche Einstellungen und Version.
Sowas taugt dann auch um den Einfluss von Hardware und Betriebssystem zu
beurteilen.
Es war mal einfach ein Projket aufzusetzen, dass bei jeder Synthese der identische Bitstream rauskommt.
Auch unsere FAEs und Kursleiter von Microchip haben bestätigt, dass mindestens Verschiedene OS Versionen (Windows / Linux) zu unterschiedlichen Bitstreams führen bei Libero SoC. Aus unserer Erfahrung ist der Einfluss von Windows 10 zu Windows 11 bei Libero SoC klein bzw. wir bekomen die selben Bitstreams.
Ich gehe mit Fpga I. einig, dass dies eigentlich nicht haltbar ist für uns. Ich arbeite (noch) für die Raumfahrt. Hier ist es wichtig, dass wir auch später nochmals die selben Ergebnisse bekommen können.
Natürlich Versionieren wir die Bitstreams und legen sie im ERP ab, aber bisher nur die, die wir auch an die Kunden ausgeliefert haben. Die internen Zwischenversionen legen wir teilweise auf dem Server ab aber nicht konsequent, weil wir können sie (bisher) bei Bedarf ja einfach neu bauen...
Ich gehe mit Fpga I. einig, dass dies eigentlich nicht haltbar ist für
uns. Ich arbeite (noch) für die Raumfahrt. Hier ist es wichtig, dass wir
auch später nochmals die selben Ergebnisse bekommen können.
Könntest du mal einen Fall skizzieren, in dem das nötig ist?
Wenn man einen bitstream gebaut hat, der getestet wurde, dann ist das DER bitstream. Ich sehe keine Notwendigkeit, innerhalb eines validen Prozesses, mehrfach denselben Schritt zu machen. Der bitstream ist ja vorhanden, archiviert und als Objekt mehrfach kopiert werden, um ihn zu duplizieren und an anderen Orten zu verwenden. Er kann z.B. ins Weltall geschickt werden, wo man ihn in den Satelliten einprogrammiert.
Der einzige Fall, wo man eine Redundanz bräuchte, wäre die Annahme, daß eine bestimmte Xilinx-Installation bei Entwickler Müller kaputt ist und einen falschen Bitstream gebaut haben könnte. Daher lässt man Meier und Schulze das gleiche bauen und checkt die Prüfsummen.
Das würde Sinn machen, stimmt aber nur in der Theorie:
Selbst wenn man alles an Datumsinformationen wegließe und den bitstream weder mit dem Erzeuger, noch dem Rechner, noch der Zeit branden würde und damit zweimal das Gleiche bekommen müsste, hat man zwei / verschiedene Daten! Diese charakterisieren sich durch die Bits am Speicherort der Festplatte, im Netz, im Archiv und sonst wo. Wenn man die Sicherheit und Korrektheit testen will, muss man diese Konformität prüfen.
Das ist zwar technisch ein anderer Fehlerfall, aber er ist der viel wahrscheinlicher! Den gilt es in erster Linie abzufangen und dabei sind eben gekapselte Prüfsummen mit Authentifizierung des Erzeugers, des Erzeugerdatums und der Erzeugerortes sowie anderen Dingen nicht nur hilfreich - sondern auch dringend nötig, um Manipulationen zu erkennen, seien sie zufällig oder gewollt.
Ein bitstream, den Herr Schneider am Freitag erzeugt hat, muss von dem, dern der Müller am Dienstag erzeugt hat, klar unterscheidbar sein, weil sonst Herr Schneider ein file auf die Station senden kann, das angeblich von Herrn Müller stammt, in Wirklichkeit aber ein von Igor in Moskau gebaut wurde und eine manipulierte Prüfsumme enthält.
Neben dem Technischen gibt es eben den funktionellen Aspekt:
Es nützt wenig, sicherzustellen, dass unterschiedliche Rechner das gleiche zustandebringen, wenn nicht klar ist, ob das Ergebnis überhaupt funktioniell stimmt.
Wie ich oben schon dargestellt hatte, ist das Hauptproblem nicht ein technischer Fehler im file, sondern ein funktioneller Mangel, weil die Programmierer was übersehen haben. Daher muss ein file getestet werden, um es freizugeben.
Wenn das der Fall ist, ist es funktionell benutzbar und es kann egal sein, mit welcher Xilinx-Version es gebaut wurde oder von wem und wann.
Es muss nur immer klar sein, welchen bitstream man hat, woher er kommt, welchen Teststatus er hat und ... dass es eben DER ist, den man getestet hat und nicht eine Replique die so aussieht wie das Original.
In den Sicherheitsbereichen in denen ich tätig war, ist auch immer das bitfile die heilige Kuh gewesen. Die Produktion und die Testabteilung haben immer das von der Entwicklung freigegebene file genommen. Sie haben das nicht aus Sourcen bauen dürfen. Sie haben auch nicht das PROM-file selber bauen dürfen. Es gab immer nur EIN bitfile, EIN prom file und EIN mask file. Deren Datumseinträge waren klar definiert, bekannt und prüfbar.
Wenn man sich diesbezüglich die FMEA vor Augen führt, wird auch klar, daß diese beiden Punkte, funktionelle Richtigkeit und technische Richtigkeit, die möglichen Problemfälle sind und deren korrekt Behandlung eventuelle "Synthesediskrepanzen" zu 100% mit erschlagen.

 xilinx_synthesis_test.jpg
(69 KB)