Hallo,

ich versuche gerade diesen Code
(http://vhdlguru.blogspot.com/2010/03/matrix-multiplication-in-vhdl.html)
zum Laufen zu kriegen mittels Quartus 2.

Ich bin mir jedoch nicht sicher wie ich diesen Code testen soll. Wenn
ich x weglasse und für die Matrizen a und b bestimmte Integer Werte
eingebe bekomme ich Datentypfehler.

Wenn ich die Matrix Einträge mittels to_unsigned(Zahl,1) konvertiere,
bekomme ich den Fehler

can't determine definition of operator ""*"" -- found 0 possible
definitions


Findet jemand den Fehler?

Danke, mfG
kurt schrieb:> can't determine definition of operator ""*"" -- found 0 possible> definitions
Das heißt, das für die Multiplikation die Du machen willst, keine
Funktion definiert ist (z.B. boolean * character). Ich hab mir den
Quelltext nicht angeschaut. Welche Datentypen stehen links und rechts
vom '*'?
Duke
hallo,

hab ich eigentlich eingebunden.
Der Code sieht so aus:

 prod(i) := prod(i) + (a(i)(k) * b(k));

wobei

a <=
((to_unsigned(1,1),to_unsigned(2,1),to_unsigned(3,1)),(to_unsigned(4,1),
to_unsigned(5,1),to_unsigned(3,1)),(to_unsigned(7,1),to_unsigned(2,1),to
_unsigned(1,1)));
b <= (to_unsigned(3,1),to_unsigned(4,1),to_unsigned(5,1));

bzw.

variable prod : t2:=(others => (others => to_unsigned(0,16)));

und

type t11 is array (0 to 2) of unsigned(15 downto 0);
type t1 is array (0 to 2) of t11; --3*3 matrix
type t2 is array (0 to 2) of t11; --3*1 matrix

mfG
kurt schrieb:> Der Code sieht so aus:> prod(i) := prod(i) + (a(i)(k) * b(k));
Warum schwant mir Übles?
> Der Code sieht so aus:
Dir ist schon klar, dass dieser Code zwar eine Matrix multipliziert,
aber einen GIGANTISCHEN Ressourcenverbrauch hat. Denn da werden ja alle
9 Multiplizierer und Addierer hintereinander parallel aufgebaut. Und die
gesamte Rechenoperation damit gleichzeitig kombinatorisch ausgeführt.
Ich tippe auf eine maximale Taktfrequenz um 20MHz auf einem schnellen
FPGA...
> to_unsigned(5,1)
Was kann das wohl nur geben?
Eine 5 auf 1 Bit breit umgewandelt?
Nur "0" oder "1"...
> Der Code sieht so aus:
Das ist zu wenig. Zeig doch einfach mal deinen gesamten Code...
mir ist noch eine Frage eingefallen:

Warum parallel aufgebaut? Ist ja eigentlich nur eine elementweise
Multiplikation von 2 Skalaren oder?

Es handelt sich dabei um 3 for loops (nicht gezeigt im Code). D.h. die
Elemente werden nacheinander berechnet.

Existieren effizientere Methoden?

danke, mfg
kurt schrieb:> Warum parallel aufgebaut?
Weil eine for-Schleife in VHDL parallele Hardware instatiiert.
> Ist ja eigentlich nur eine elementweise> Multiplikation von 2 Skalaren oder?
Aber eben GLEICHZEITIG.
> Es handelt sich dabei um 3 for loops (nicht gezeigt im Code). D.h. die> Elemente werden nacheinander berechnet.
Nein. Die Funktion
1
functionmatmul(a:t1;b:t2)returnt3is
wird in der Zeit 0 abgearbeitet. Das heißt so schnell wie möglich und
ohne isrgendwelche Verzögerungen. In der Praxis wirst du da natürlich
Laufzeiten durch die Multiplizierer und Addierer haben, die dir dann die
maximale Taktfrequenz beschränken.
kurt schrieb:> der Code entspricht diesem hier
Sicher nicht. Der Code dort hat ja nicht mal eine Entity oder ein
Package...
Und falls doch: kein Wunder, dass das nicht geht. Sieh dir mal an, wie
ein VHDL-Modul aufgebaut ist. Da steht am Anfang immer sowas:
1
libraryIEEE;
2
useIEEE.STD_LOGIC_1164.ALL;
3
:
4
:
> Existieren effizientere Methoden?
Definiere "Effizienz"!
Wo sind die Daten gespeichert? In einem RAM?
Wie greifst du darauf zu?
Kommen die Daten über eine Schnittstelle?
wenn du bei den erwähnten Link ein bisserl runterscrollst siehst du den
gesamten Code (bei den Kommentaren)

mit den Files mat_ply.vhd, test_mat.vhd, und mat_tb.vhd


mfG
Effizienz bzgl Ressourcenverbrauch meinte ich.

Die Daten werden später mal in irgendeinem Speicher liegen ja. Aber
derzeit möchte ich einfach nur mal die Multiplikation überprüfen -
jedoch weiß ich nicht wie ich den Code testen kann. Ich hatte eigentlich
vor die Matrizen einfach vorzudefinieren - anstatt dem x. Ist das
möglich?
kurt schrieb:> Ich hatte eigentlich vor die Matrizen einfach vorzudefinieren -> anstatt dem x. Ist das möglich?
Ja.
kurt schrieb:> derzeit möchte ich einfach nur mal die Multiplikation überprüfen
Warum denn? Die wird schon gehen...
kurt schrieb:> Nur weiß ich leider nicht wie ich den Code testen soll?
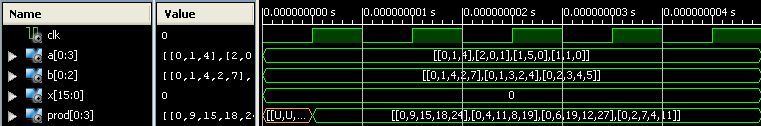
Ich habe einfach in Xilinx ISE ein neues Projekt gemacht, alles in 1
Datei reinkopiert, gespeichert und die Simulation gestartet. Und die
lief soweit problemlos (siehe Screenshot)...
> Effizienz bzgl Ressourcenverbrauch meinte ich.
Eine Synthese dieses Codes ergibt:
Advanced HDL Synthesis Report
Macro Statistics
# Multipliers : 60
16x16-bit multiplier : 60
# Adders/Subtractors : 40
32-bit adder : 40
# Registers : 640
Flip-Flops : 640
Allein diese Rechenoperation füllt ein S3 1000er FPGA zu 79%... :-o
Aber die Taktfrequenz ist für S3 1000er FPGA doch immer noch 50MHz, das
kann das offenbar besser als ich gedacht habe...
Um effizienter zu werden, mußt du das so machen, dass du nur 1
Multiplizierer verwendest, und alle Elemente nacheinander aus dem
Speicher holst, multipliziertst und wieder abspeicherst. Das passt dann
nicht mehr auf 1 Bildschirmseite (oder bestenfalls nur bei sehr
effizienter Schreibweise)...
Hallo,

danke für die Antwort und den anschaulichen Screenshot.

Bei mir funktionierts komischerweise nicht.

error: u.a can't fit design in device

Ich verwende das Cyclone II EP2C35F672C6 board. Könnte es u.a. sein dass
der Hardware-Aufwand einfach zu groß ist.

könntest du den Code bitte anhängen.

danke, mfg
kurt schrieb:> error: u.a can't fit design in device>> Ich verwende das Cyclone II EP2C35F672C6 board. Könnte es u.a. sein dass> der Hardware-Aufwand einfach zu groß ist.
Jepp. Genau das besagt die Fehlermeldung.
Wieviele Multiplizierer hat denn Dein Cyclone II?
Und wie schnell muß denn Deine Matritzenmultiplikation stattfinden?
Duke
kurt schrieb:> Ich verwende das Cyclone II EP2C35F672C6 board. Könnte es u.a. sein dass> der Hardware-Aufwand einfach zu groß ist.
Ja. Da steht es:
> error: u.a can't fit design in device> könntest du den Code bitte anhängen.
Ähm, du selber schriebst doch:
kurt schrieb:> wenn du bei den erwähnten Link ein bisserl runterscrollst siehst du den> gesamten Code (bei den Kommentaren)
Und ich habe dann nur noch das gemacht:
> Ich habe einfach in Xilinx ISE ein neues Projekt gemacht, alles in 1> Datei reinkopiert, gespeichert und die Simulation gestartet.
Aber bitte: die Datei ist im Anhang... ;-)
Die geht für die Simulation. Für die Synthese musste ich natürlich die
Testbench auskommentieren...
Nehmen wir an ich möchte a und b fix vorgeben und ich setze das x mal
unter Kommentar.

Außerdem möchte ich z.B. die Matrix Einträge via integer Zahl fix
vorgeben.

Hab das ganze mal für eine 2x2 Matrix probiert und die Matrizengrößen
entsprechend geändert.

a und b definiere ich folgend:

a <= to_unsigned((5,16),(3,16)),to_unsigned((1,16),(2,16));
b <= to_unsigned((2,16),(1,16)),to_unsigned((3,16),(2,16));


Folgender error:
TO_UNSIGNED type specified in Qualified Expression must match t1 type
that is implied for expression by context


to_unsigned verwende ich um von integer nach unsigned zu konvertieren,
16 ist die Länge bezüglich t1.

Was fehlt noch? std_logic_vector? bzw. wie muss ich es anwenden.
kurt schrieb:> to_unsigned((5,16),(3,16))
Was erwartet die Funktion to_unsigned()?
Richtig: EINEN Wert und EINE Wortbreite.
Wenn, dann also so:
(to_unsigned(5,16),to_unsinged(3,16))
ok danke jetzt hab ich es verstanden.

Angenommen ich möchte als Matrixeinträge Kommazahlen verwenden. Und bei
der Multiplikation so wenig an Genauigkeit verlieren wie nur möglich.

Was ist der effizienteste Weg dafür? Konvertierung zu real?

mfg
kurt schrieb:> Angenommen ich möchte als Matrixeinträge Kommazahlen verwenden.
Was sind Kommazahlen?
Meinst du eine Gleitkommazahl?
http://de.wikipedia.org/wiki/Gleitkommazahl
Wie ist eine Kommazahl z.B. entsprechend IEE 754 definiert?
Wie sieht die Darstellung auf Bitebene aus?
Wie müsste dann ein simpler Addierer aussehen?
Merkst du was?
> Was ist der effizienteste Weg dafür? Konvertierung zu real?
EXTREMER AUFWAND!!!
Hallo,

Gleitkommazahlen sind folgend definiert:
zahl=Vorzeichen*2 hoch (exponent) *mantisse

ein simpler Addierer müsste dann einfach zwei 32bit zahlen addieren.
Jedoch frag ich mich wie ich eine Zahl (z.B. 3.52) in diese IEEE 754
Darstellung bekomme. Gibts dafür einen vordefinierten Befehl.

und die 16 Bit unsigned Typen müsste ich dann wahrscheinlich alle auf 32
Bit erweitern oder?

Bzw. was muss ich statt unsigned verwenden?

mfg
kurt schrieb:> und die 16 Bit unsigned Typen müsste ich dann wahrscheinlich alle auf> 32 Bit erweitern oder?
Es ist tatsächlich WESENTLICH komplizierter und deshalb wird meist mit
Festkommazahlen gerechnet. Das sind eigentlich "normale" Integer (womit
auch alle bekannten Rechneverfahren wieder problemlos funktionieren) und
bekommen nur irgendwo "gedanklich" ein Komma reinzentriert...