OCR in Script-Programmen unter Windows

OP #3359187
Innerhalb vom Skript brauche ich OCR, um Bildschirminhalte zu 
untersuchen.
Tesseract schien mir sinnvoll.
Gerade die neueste Version installiert (3.0.2) bin ich sehr unzufrieden.

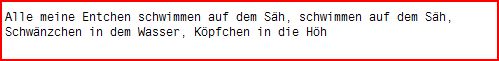
Ich habe mal einen Editor-Text als Grafik scannen lassen.
1
c:\Users\Public\Tesseract-OCR\tesseract.exe  snip1.JPG  1.txt
Heraus kommt:

we meme Entchen schwuumen auf dem Ssh scnmmmen auf dem Ssh
Scmvanzchen my new Nasser Kopfchen my me Huh


Also, da hätte ich mehr erwartet.
Was wären Alternativen?
Angehängte Dateien:
OP
Ja, defaultmässig wird wohl englisch installiert worden sein.
Ich will mich nicht auf eine Sprache festlegen, da es universell nutzbar 
sein soll.

Aber bei so einer klaren Grafik hätte ich eine 100%-ige Erkennung 
erwartet.
Die Voraussetzungen sind hier ideal und nicht wie bei einem Papier-Scan 
(schiefe linien, Dreck/Staub-Pixel, ...)
Gast
nuja, mit englischem abgleich-wörterbuch sind die punkte über den 
umlauten dreck.
offensichtlich kann ocr auch 2013 immernoch nicht richtig "lesen" und 
muss auf tricks zurückgreifen um die "erkennungs"rate zu verbessern - 
und in diesem fall scheint der trick direkt mal eine verschlechterung 
bewirkt zu haben.
OP
Das könnte ein Antwort sein:

http://markmail.org/message/idoes77vyhuq45ww#query:+page:1+mid:2llgcorkppvrdgnv+state:results
I believe the previous response is correct:  tesseract needs
characters to have a a pretty large height in terms of pixels.  There
is probably something in the FAQ.  On 4-21-09 I had a post with more
details.

On Aug 5, 9:24 am, jia <jiap...@gmail.com> wrote:
Hello, group,

I'm trying to use tesseract to recognize text in screen capture
images. However, tesseract doesn't recognize anything on the font size
commonly used in GUI. See the file named "capture.tif" for an example.
However it does work on larger font. I suspect it has to do with the
very thin stroke in smaller font. If that's the case, is there any
parameters I can tune to make it work on smaller font?


Die Buchstaben-Höhe in Pixel sind bei einen PapierScan natürlich größer 
(Resolution >= 300dpi vorausgesetzt)
Vermutlich kann Tesseract kleine Pixelhöhen nicht handeln, trotz 
sonstigen idealen Bedingungen (kein Rauschen, exact horizontal-gerade 
Linien ...)
Gast
Abgesehen vielleicht von der Hòhe hat Tesseract ein Problem, wenn die
Breite zu nahe zusammen ist. Man kann dies hier auch schòn erkennen.
Deshalb wird oft auch OpenCV oder Leptonica dazu verwendet, die 
Buchstaben
zu trennen und dann Tesseract einzeln zuzufuehren. Dann funktioniert es.
Gast
Und setze diese auf false damit die Woerter nicht Englisch werden.

load_system_dawg
load_freq_dawg
load_punc_dawg
load_number_dawg
load_unambig_dawg
load_bigram_dawg
load_fixed_length_dawgs
OP
> Deshalb wird oft auch OpenCV oder Leptonica dazu verwendet, die
> Buchstaben
> zu trennen und dann Tesseract einzeln zuzufuehren. Dann funktioniert es.

Fehlanzeige. Leptonica ist schon dabei. Das sieht man an der Ausgabe.


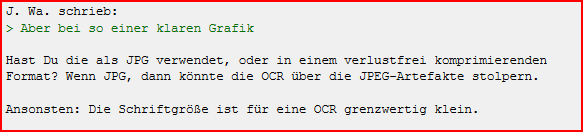
> Wenn JPG, dann könnte die OCR über die JPEG-Artefakte stolpern.
Ich habe es nochmal mit PNG versucht. Das Ergebnis ähnlich übel.

1
H:\tmp>c:\Users\Public\Tesseract-OCR\tesseract.exe  Snip1.PNG  1.txt
2
Tesseract Open Source OCR Engine v3.02 with Leptonica
3

4

5
H:\tmp>more 1.txt.txt
6
.7. Ha. schxxab:
7
> Abe: be) so elngr ldazen Gxafxk
8

9
Has: nu ma als are vuuenaec, ndex m elnun vgrlustfxex kanlpzunexgnden
10
Fnzmac? Vknn .195, dann kénnt: d1: ocn ubex dle .7'El5—Az::fak:e scclpun.
11

12
Anannslzen: D1: Schxxfbqiéfle 1;: fix: use ocn qrenzwertlq klem.
Angehängte Dateien:
OP
Ich habe das ganze mit Abbys Finereader 9.0 probiert.
Da kam die Warnung, dass keine Resolution eingetragen ist, und er von 
300dpi ausgeht.
Finereader konnte keinen einzigen Buchstaben erkennen.

Dann habe ich manuell die Auflösung auf 96dpi geändert und alle 
Buchstaben wurden sauber erkannt.
Allerdings konnte er keine speziellen Buchstaben (Ñ ñ é)
Gast
Eine OCR-Erkennung von 99% heißt auch, daß jeder 100. Buchstabe falsch 
sein kann. Schlechter wird die Erkennung noch, wenn der Text nicht im 
Wörterbuch zu finden ist oder schon 3x kopiert wurde.

Antwort schreiben

Eine eigene Frage? Dieser Thread ist über 13 Jahre alt. Stell sie in einem eigenen Thread – dort lesen mehr Leute mit, und sie wird öfter und schneller beantwortet.

Neuen Thread starten

Eine Lösung, Ergänzung oder Rückmeldung zu diesem Thread? Dann antworte hier.

Formatierung
  • [c]C-Code[/c]
  • [code]Code in anderen Sprachen, ASCII-Zeichnungen[/code]
  • [math]Formel in LaTeX-Syntax[/math]
  • [[Titel]] – Link zu einem Artikel
  • Verweis auf einen anderen Beitrag: Rechtsklick auf dessen Beitrags-ID (#8078628), „Adresse kopieren“, in den Text einfügen

Mehr zur Formatierung

Längeren Sourcecode als Anhang, nicht in den Text. JPG nur für Fotos und Scans; Zeichnungen und Screenshots als PNG oder GIF. Siehe Bildformate.

Schon registriert? Anmelden

Wird nicht angezeigt. Wir schicken dir einen Link; sobald du damit bestätigst, erscheint dein Beitrag.

Mit dem Abschicken legst du einen kostenlosen Account an und erkennst die Nutzungsbedingungen und die Datenschutzerklärung an.