Hallo,

Der Cortex-M4 hat ein LDRD Bug, der zur HardFaultException führt.

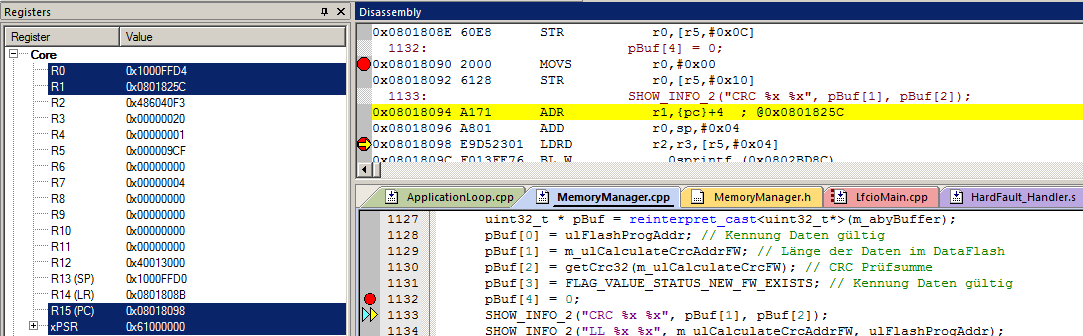
Anbei der Screenshot vom Keil Debugger. Immer wenn in R5 eine nicht 4
Byte Aligned Adresse steht dann macht der LDRD eine Exception.

Die Deklaration des Buffers sieht so aus:
uint8_t m_abyBuffer[512];

Wenn ich das so abändere, dann wird der Buffer wie gewünscht aligned:
union {
uint8_t m_abyBuffer[512];
uint32_t m_abyBuffer32[128];
};
und es kommt keine Exception mehr.

Solche Fehler zu finden ist recht mühsam. Keil bietet von Haus aus auch
keine Möglichkeit den µC Bug zu umgehen.
Die Option "--no_unaligned_access" hilft auch nicht in diesem Fall.

Weiß jemand wie man sicherstellen kann dass Keil mir keinen Buggy Code
generiert? Das Problem ist zwar nun an der Codestelle beseitigt, aber
wie kann ich sicher sein dass nicht noch an anderer Stelle das gleiche
passiert?

__aligned(4) vor der Variable geht in der C++ Klasse leider nicht.

Grüße Markus
Markus M. schrieb:> Der Cortex-M4 hat ein LDRD Bug, der zur HardFaultException führt.
Das ist kein Bug, das ist bei ARMv7M grundsätzlich so.
Markus M. schrieb:> __aligned(4) vor der Variable geht in der C++ Klasse leider nicht.
Verwende einen anständigen Compiler wie GCC, der kann das. Der kann
insbesondere C++11, welches das sogar vorschreibt (alignas keyword).
Jedenfalls habe ich was programmiert und der µC ist abgestürzt. Dann hat
der Compiler wohl den LDRD Befehl falsch verwendet.
>> Bug vom Keil.

Wenn ich dürfte dann hätte ich GCC verwendet. Den Compiler hat der Kunde
vorgeschrieben.
Markus M. schrieb:> Dann hat> der Compiler wohl den LDRD Befehl falsch verwendet.
Nein.
Bug deines Codes.
Woher soll Keil wissen, dass du auf unaligned zugreifen willst?. Du
machst dir mit deinem cast das Prinzip "Packed, unaligned ?-> Byteweise
zugreifen" des Kompiler selbst kaputt.
Oder stellst du dir vor, das Keil grundsätzlich mit 8 Bit
Speicherzugriffen arbeitet wenn er 32 Bit verarbeiten muss?
Das verstehe ich schon, aber gibt es eine Möglichkeit das heraus zu
finden wo überall im Code sowas auftritt, bzw. vergraben sein könnte?
Ich habe hier mehrere 10000 Zeilen Code in Zig Dateien die mehrere Leute
geschrieben haben.
Ich habe mir die Assembler Listings erzeugen lassen und bin die LDRD
durchgegangen, das sollte nun alles gut sein. Aber wenn weiter
programmiert wird kann sowas wieder rein kommen - wie auch immer.

Ich wollte mir die Arbeit sparen jedes mal die Assembler Listings durch
zu gehen.
Markus M. schrieb:> Jedenfalls habe ich was programmiert und der µC ist abgestürzt. Dann hat> der Compiler wohl den LDRD Befehl falsch verwendet.>>> Bug vom Keil.
Was sagt Keil den dazu? Wie sieht den Dein Zugriff auf das Array aus?
Über einen Zeiger auf einen Typen, der ein anderes aligment hat?
Markus M. schrieb:> Ich habe hier mehrere 10000 Zeilen Code in Zig Dateien die mehrere Leute> geschrieben haben.> Ich habe mir die Assembler Listings erzeugen lassen und bin die LDRD
Das bringt dich auch nicht weiter. Das Phänomen kann auch mit anderen
Opcodes auftreten.
Du musst da schon durch deine Quelltexte durch und dir deine Casts
anschauen. Wenn du auf 16 Bit zugreifst und die Adresse nicht
Halbwort-ausgerichtet ist, knallt es.
Wenn du auf 32 Bit zugreifst und die Adresse nicht Wort-ausgerichtet
ist, knallt es.
Bei Operationen ohne Casts, kümmert sich der Compiler darum die entweder
so zu legen, dass sie aligned sind, oder bei packed eben nur mit
erlaubten Operationen auf unaligned zuzugreifen. (Das Problem tritt auch
dauf deinem PC bei z.B. SSE auf)
Für Zwecke, wie Framing etc., wo die Struktur von aussen in einen Puffer
eingebracht wird, nutze ich persönlich eine einmal geschriebene CHUNK
Klasse. Per << Werte hinzufügen, per >> entfernen. Seek, Cut, Skip dazu.
Je nach Typ und Pufferposition wird dann der passende Zugriff verwendet.
Man kann den Endianess umstellen und hat keine Probleme durch falsche
externe Angaben (Längen, etc) out of bounds zuzugreifen und damit
Speicher zu überschreiben.
Maxx schrieb:> Du musst da schon durch deine Quelltexte durch und dir deine Casts> anschauen. Wenn du auf 16 Bit zugreifst und die Adresse nicht> Halbwort-ausgerichtet ist, knallt es.> Wenn du auf 32 Bit zugreifst und die Adresse nicht Wort-ausgerichtet> ist, knallt es.
Bei Cortex M4 normalerweise nicht. Die meisten LDR und STR Instruktionen
können mit nicht ausgerichteten Addressen umgehen (was man übrigens
explizit abschalten kann).
LDRD und STRD sind der Sonderfall wo das immer einen Fault gibt, ebenso
wie floating point Instruktionen.
Das Dumme daran ist, das der Compiler diese Instruktionen auch zum
Beispiel bei aufeinander folgenden 32 Bit Zugriffen generieren kann, und
das dieses Verhalten vom Optimizer beeinflusst wird. Dadurch können
solche Alignment Bugs den Programmierer überraschen.
Markus M. schrieb:> Das verstehe ich schon, aber gibt es eine Möglichkeit das heraus zu> finden wo überall im Code sowas auftritt, bzw. vergraben sein könnte?> Ich habe hier mehrere 10000 Zeilen Code in Zig Dateien die mehrere Leute> geschrieben haben.
Castet ihr so häufig von kleinen Datentypen auf große?
Es gibt viele Prozessoren, die das nicht mögen.
So häufig casten wir auch nicht.

Dieser Fall, da ist der Buffer ein Buffer für die Ausgabe auf SPI zum
externen Flash. Hin und wieder werden da nicht einfache Bytes, sondern
auch formatierte Daten übergeben, so wie in dem Fall ein Array mit
uint32_t. Und da liegt es nahe den Pointer des Puffers in die
entsprechende strukturierte Variable zu casten damit man schön darauf
zugreifen kann.
Es gibt somit nur 1x Speicherverbrauch und der wird flexibel genutzt.

Richtiger weise müsste man diesen Buffer mittels union{} auf alle
möglichen Strukturen zusammen fassen, dann würde das Problem auch nicht
auftreten.

So habe ich es nun auch gemacht, damit wird der Compiler gezwungen
4-Byte aligned den Speicherbereich an zu legen.
Es betrifft nur Speicherbereiche von Datenströmen, wie z.B. UART oder
SPI.
Markus M. schrieb:> Den Compiler hat der Kunde vorgeschrieben.
Auch nicht IAR statt Keil? Dort scheint es gefixt:
The compiler now avoids the LDRD instruction with the base register in
list when generating code for Cortex-M3
Markus M. schrieb:> Richtiger weise müsste man diesen Buffer mittels union{} auf alle> möglichen Strukturen zusammen fassen, dann würde das Problem auch nicht> auftreten.
dafür ist aber eine Union nicht wirklich da. Eigentlich sollte/darf man
nur Datentype lesen den man vorher auch geschrieben hat.
Wirklich sauber ist es nur mit einem memcpy in die neu Struktur. Kostet
natürlich etwas Rechenzeit und Speicher.
Das LDRD Problem mit einem Cortex-M3 haben wohl in der Zwischenzeit alle
Compiler gefixt. Der Cortex-M4 hat dieses LDRD Problem auch gefixt.
Aber das hier ist ein anderes Problem.
Eine eigene Frage?
Dieser Thread ist über 11 Jahre alt.
Stell sie in einem eigenen Thread – dort lesen mehr Leute mit, und sie wird öfter und schneller beantwortet.

 Bild1.png
(45 KB)