Tim  . schrieb:
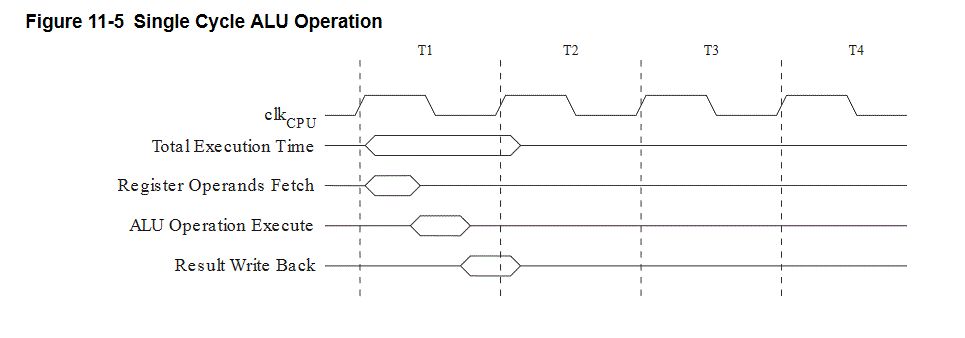
> Das Bild ist gemeint?
>
> Das ist ein rein kombinatorischer Vorgang. Erst der Write-Back führt
> wieder zum latching der Daten. Da nichts besonders dran und es sind auch
> keine "sub-clocks" notwendig.

Yep. Etwas irreführend an dem Bild ist, daß das Lesen der Operanden, die
Verarbeitung und das Writeback so dargestellt ist, als wären es drei
separate Vorgänge. Sind sie nicht. Das passiert alles gleichzeitig. Am
Beginn des Zyklus schaltet ein Multiplexer die beiden Operanden auf die
Eingänge der ALU. Die ALU selber führt praktisch ununterbrochen ihre
Arbeit durch (ein paar Bits aus dem Befehlsdecoder sagen ihr dabei, was
genau sie  tun soll, z.B. ADD oder AND). Und am Ende des Zyklus wird das
Ergebnis aus der ALU im Zielregister gelatcht.

> Natürlich erlaubt eine solche Architektur keine sehr hohen
> Taktfrequenzen

Entscheidend ist nicht die Taktfrequenz, sondern der Durchsatz. Wenn man
mehr Verarbeitungsschritte asynchron macht, dann braucht es wegen der
Laufzeiten natürlich länger, bis das Ergebnis "steht". Wenn man die
Verarbeitung in kleinere, taktsynchrone Einheiten aufteilt, dann wird
zwar jede Einheit für sich schneller fertig, aber die Instruktion
braucht am Ende genauso lange oder sogar länger.

Klassisches Beispiel ist Z80 vs. 6502. Der erstere ist synchron
aufgebaut und braucht entsprechend mehr Takte pro Instruktion. In der
Praxis sind ein Z80 bei 2.5MHz und ein 6502 bei 1MHz ungefähr gleich
schnell.